Anthropic cria IA para construir e interpretar modelos
Novo artigo apresenta como bolsistas do AI for Science estão usando agentes LLM para propor, comparar e interpretar famílias de modelos científicos, ampliando a descoberta em áreas como neurociência.

Danilo Gato
Autor
Introdução
A IA para modelos científicos ganhou um passo concreto com a publicação de 6 de novembro de 2026, assinada por bolsistas do AI for Science ligados ao ELLIS Institute Tübingen. O grupo descreve como agentes com LLM constroem, comparam e interpretam famílias inteiras de modelos, em vez de buscar um único ajuste, o que muda a prática e amplia a inferência a partir de dados. (anthropic.com)
A proposta parte de um ponto simples e poderoso, a IA para modelos científicos precisa evitar a armadilha do “melhor ajuste único”. Em vez disso, o agente gera muitos candidatos, pesa cada um pelo suporte dos dados, elimina opções frágeis e retorna uma distribuição de modelos plausíveis. Essa visão favorece entendimento, não só acurácia, e ajuda a planejar experimentos que descartem grandes regiões do espaço de hipóteses. (anthropic.com)
O que este artigo aborda
- Como agentes com LLM constroem e refinam famílias de modelos a partir de dados e descrições naturais. (anthropic.com)
- Por que distribuições de modelos elevam a interpretabilidade e a qualidade de inferências científicas. (anthropic.com)
- Ligações com avanços recentes em descoberta de equações e regressão simbólica. (nature.com)
- O contexto do programa AI for Science da Anthropic e o foco crescente em pesquisas de alto impacto. (anthropic.com)
Como agentes com LLM constroem famílias de modelos
Os autores relatam um ciclo de projeto, execução e revisão, em que o LLM escreve código para modelos candidatos, roda simulações, compara saídas com dados reais e modifica a forma das equações conforme necessário. Em vez de devolver uma resposta determinística, o sistema retorna uma distribuição de modelos, cada qual ponderado pelo suporte empírico. Isso torna explícito o que está realmente ancorado nos dados e o que ainda é suposição. (anthropic.com)
O exemplo histórico de Hodgkin e Huxley, em 1951, ilustra a diferença entre ajustar curvas e gerar entendimento. O termo de quarta potência emergiu do confronto entre hipóteses alternativas e dados, e só ganhou peso porque versões mais simples falharam. A abordagem atual com LLM acelera o ciclo, porém mantém a lógica de confrontar espaços de modelos, o que dá sustentação causal às inferências. (anthropic.com)
Essa estratégia converge com a literatura recente de regressão simbólica e descoberta de equações, em que o objetivo é encontrar expressões compactas e interpretáveis a partir de dados. Estudos de 2025 e 2026 reforçam que SR ganha tração como técnica para recuperar relações mecanísticas e produzir fórmulas legíveis, em saúde e engenharia, com avaliação de interpretabilidade mais rigorosa. (nature.com)
Construção, não só ajuste, por que a distribuição importa
Focar em uma única hipótese mascara a incerteza estrutural. Segundo o artigo, quando o agente considera a vizinhança de modelos que explicam igualmente bem os dados, certos traços comuns surgem, o que permite afirmações mais robustas, enquanto divergências entre famílias apontam lacunas de evidência e próximos experimentos. Em neurociência, por exemplo, bloquear todos os canais de sódio deve produzir previsões convergentes entre modelos, já intervenções parciais revelam onde a teoria ainda é frágil. (anthropic.com)
Esse raciocínio dialoga com práticas consolidadas em clima e física de partículas, campos que historicamente reportam faixas de projeção e mapas de exclusão de teorias, não verdades monolíticas. Na agenda de IA científica, a consequência prática é investir em pipelines que devolvam não uma equação, mas um portfólio de equações ponderadas. (anthropic.com)
Nos últimos 12 meses, houve progresso consistente em frameworks que tornam essa busca mais eficiente. Na ICML 2026, um método de “evolução deliberada” mostrou ganhos de amostra ao usar raciocínio agentivo para orientar a exploração do espaço simbólico, reduzindo o custo de avaliação. Outro trabalho na UAI 2026 introduziu um critério bayesiano com reforço entrópico para equilibrar desempenho e interpretabilidade. Esses resultados convergem no sentido de que a qualidade do espaço de busca e a medida de simplicidade importam tanto quanto erro quadrático médio. (proceedings.mlr.press)
Interpretabilidade aplicada, de fórmulas a mecanismos
Interpretar um modelo significa inferir o que, no mundo, deve ser verdadeiro para que as equações funcionem. O artigo enfatiza que essa é a parte mais difícil de automatizar, porque envolve objetivos como inteligibilidade humana e capacidade de prever efeitos de intervenções. Um caminho é avaliar se a família de modelos acerta perturbações, outro é verificar se as saídas do agente ajudam cientistas a formular melhor o problema, por exemplo, ao projetar famílias de experimentos quânticos. (anthropic.com)
A discussão acompanha uma virada mais ampla na comunidade, que questiona métricas tradicionais de “pós explicação” e busca critérios mecanísticos e neuro simbólicos mais fortes para auditoria e intervenção antes da decisão. Propostas recentes argumentam que interpretabilidade em ciência não deve ser confundida com esparsidade, e defendem definições operacionais que guiem avaliação reprodutível. (arxiv.org)
Na prática, SR e abordagens híbridas ajudam a materializar esse ideal, já que oferecem fórmulas explícitas e passíveis de inspeção. Revisões de 2026 propõem estruturas para pontuar interpretabilidade, além de seleção informada por física, reduzindo a chance de fórmulas equivalentes enganarem análises. (sciencedirect.com)
Caso de uso em escala, do neurônio à mosca da fruta
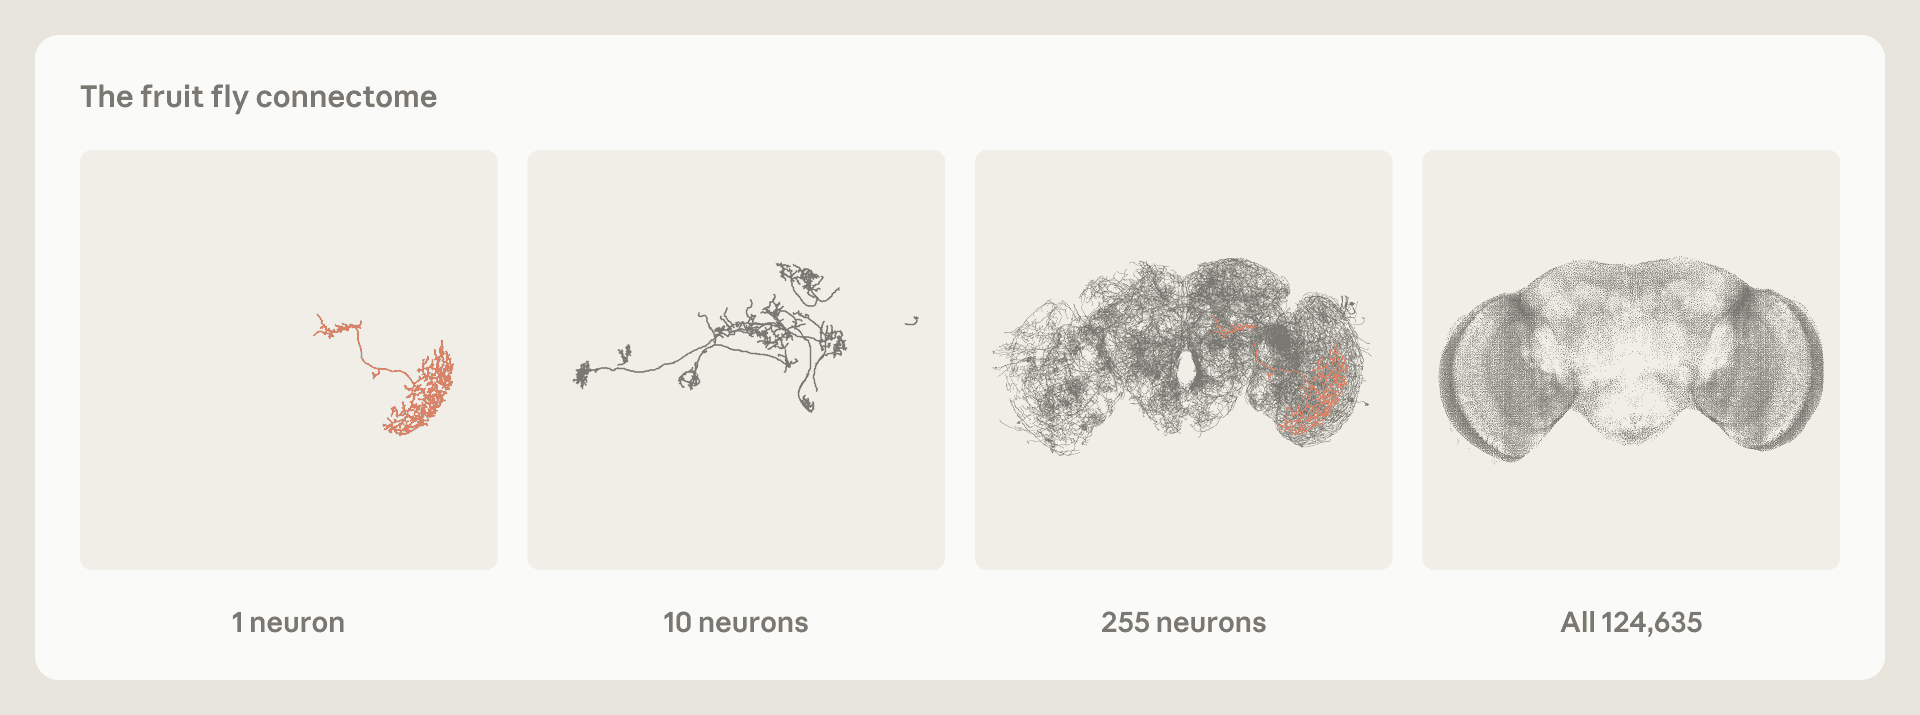
O post traz um exemplo que deixou de ser ficção científica, a conectômica da mosca da fruta agora tem o diagrama completo de fiação, com 124.635 neurônios, o que permite construir modelos em múltiplas escalas a partir de dados anatômicos. A possibilidade de gerar e comparar famílias de modelos nesse nível abre perguntas profundas sobre como a conectividade dá origem a comportamento e percepção, e quais conexões realmente importam para funções específicas. (anthropic.com)
O aspecto pedagógico é igualmente relevante. Quando o agente explica quais regiões do espaço de modelos foram descartadas e por quê, cientistas ganham “histórico de raciocínio” que lembra o processo manual clássico, porém em horas, não semanas. Isso mantém o vínculo entre mecanismo e dado, reduz overfitting estrutural e sugere intervenções experimentais com maior rendimento informativo. (anthropic.com)
Onde a Anthropic está posicionando a IA para ciência
O programa AI for Science foi lançado com o objetivo de acelerar descobertas via acesso a APIs e créditos para grupos de alto impacto. Em outubro de 2026, a empresa relatou ter expandido o programa e iniciado um preview do Model Hardware Standard, para operação segura de instrumentos de laboratório por agentes. A estratégia inclui integrar o ecossistema científico por meio de conectores e padrões de contexto, além de parcerias em biomedicina. (anthropic.com)
Em saúde, relatos públicos recentes mostram o uso de Claude em desenho de anticorpos e triagem de candidatos terapêuticos, numa linha que reforça a ambição de atravessar do texto para decisões experimentais. Essa transição pressiona por interpretabilidade mais forte, já que os outputs deixam de ser documentos e passam a ser ações em laboratório. (techradar.com)
Regressão simbólica está amadurecendo
Nos últimos meses, artigos de revisão e benchmarks apontam duas frentes. Primeiro, a eficiência amostral com agentes LLM para SR melhorou, graças a laços de raciocínio e feedbacks mais ricos do que um único erro escalar. Segundo, critérios de seleção e interpretação ficaram mais cuidadosos, usando noções informacionais, priores físicos e testes de equivalência algébrica para evitar fórmulas diferentes mas semanticamente idênticas enganarem a análise. O saldo é uma SR mais pronta para domínios onde interpretabilidade é requisito, como clínica e engenharia. (proceedings.mlr.press)
Há também aplicações fora do “cânon” físico, como comportamento no tráfego. Um trabalho recente demonstrou que um framework incremental com LLM e recuperação por RAG redescobriu modelos clássicos de seguimento de carro e sugeriu novas fórmulas plausíveis, mantendo legibilidade. Esse tipo de resultado encoraja levar a abordagem para fenômenos complexos onde a resposta ótima ainda é controversa. (doi.org)
O que muda no fluxo de trabalho científico
- Geração de hipóteses, deixa de ser uma única equação, passa a ser um conjunto ponderado de candidatas, com trilhas de auditoria e rejeições explícitas. (anthropic.com)
- Planejamento experimental, prioriza intervenções que mais comprimem a incerteza de modelo, inspirando práticas de exclusão como em clima e LHC. (anthropic.com)
- Avaliação, incorpora métricas de interpretabilidade, critérios informacionais e priores físicos, além de verificação de equivalências simbólicas. (sciencedirect.com)
- Documentação, relatórios passam a incluir a distribuição de modelos, as evidências de suporte e as regiões descartadas, o que melhora reprodutibilidade e revisão por pares. (anthropic.com)
Limites atuais e pontos de atenção
Os próprios autores são claros, a evidência de que agentes constroem bons modelos em problemas sem resposta conhecida ainda é limitada, embora novos LLMs tenham avançado em tarefas de pesquisa. O campo precisa de padrões de avaliação que valorizem insight mecanístico, não só predição, e de experimentos que discriminem entre famílias de hipóteses. (anthropic.com)
Na fronteira regulatória e institucional, iniciativas como laboratórios de garantia de IA em saúde e validações locais são citadas como vias para adoção responsável. Em paralelo, cresce a literatura que sustenta a importância de definições operacionais de interpretabilidade específicas para a ciência, evitando confusões com parcimônia ou simples complexidade de fórmulas. (nature.com)
Reflexões e insights práticos
- Priorizar distribuições, plataformas internas devem expor APIs que devolvam múltiplas hipóteses com pesos, além do “melhor modelo”. Isso encurta o caminho para previsões robustas sob intervenção. (anthropic.com)
- Unir SR e agentes, incorporar laços agentivos que proponham, testem e refinem expressões com feedbacks ricos, melhorando a eficiência de busca e a rastreabilidade. (proceedings.mlr.press)
- Adotar critérios físicos e semânticos, aplicar checagens de equivalência e seleção informada por leis e dimensões, reduzindo falsos ganhos de interpretabilidade. (sciencedirect.com)
- Trazer dados do laboratório, conectar agentes a bases biomédicas e ferramentas de bancada de maneira segura, meta em que a Anthropic reporta progressos via conectores e padrões de contexto. (anthropic.com)
Conclusão
O anúncio de 6 de novembro de 2026 consolida uma mudança metodológica, a IA para modelos científicos não precisa mais perseguir uma única fórmula. Gerar e interpretar distribuições de modelos devolve o protagonismo ao entendimento e prepara melhor o terreno para decisões experimentais. A combinação de agentes LLM, regressão simbólica e critérios mecanísticos cria um caminho de impacto, inclusive quando a resposta certa ainda é desconhecida. (anthropic.com)
O próximo passo está em ampliar validações fora do “currículo escolar” da ciência, estressando métodos em problemas realmente abertos. Com padrões de avaliação mais maduros e integrações seguras com dados e instrumentos, a promessa de IA que constrói e interpreta modelos pode se traduzir em descobertas confiáveis, reprodutíveis e úteis no mundo real. (anthropic.com)
Leia também
As 14 histórias de IA mais importantes desta semana, por Matt Wolfe no YouTube, Show TLDR
As 14 histórias de IA mais importantes desta semana, inspiradas no formato Show TLDR do Matt Wolfe, reúnem anúncios de modelos da OpenAI e Google, novas políticas para escolas, avanços em segurança e avaliações independentes. Entenda o que muda no desenvolvimento de produtos, na governança de IA e na segurança cibernética. Veja como aproveitar oportunidades e evitar armadilhas.
9 min de leituraInteligência ArtificialOpenAI lança BioBasicsBench, teste de IA no wet lab
BioBasicsBench é o novo benchmark da OpenAI para medir como agentes de IA analisam dados brutos do wet lab, detectam erros e sabem quando os resultados não sustentam conclusões. Desenvolvido com a Ligo, abrange 100 tarefas reais, resultados detalhados e limites claros, trazendo visão prática sobre segurança e aplicações.
9 min de leituraInteligência ArtificialClaude da Anthropic joga EVE para estudar mercados e equipes
Anthropic colocou Claude para jogar EVE Online e EVE Frontier com um objetivo claro, entender como agentes de IA negociam em mercados e colaboram em times. O estudo Project EVE revela ganhos consistentes em simulação de mercado, quedas quando a tarefa exige prever direção de preços e dificuldades em detectar sabotagem sutil em equipes. Veja os dados, implicações e como aplicar as lições em produtos e operações.
11 min de leituraInteligência ArtificialOpenAI remove NDAs com autoridades públicas em data centers
A OpenAI anunciou que deixará de exigir NDAs de autoridades públicas em negociações de data centers. A medida, somada a compromissos de transparência sobre água, ruído e planos de construção, tenta responder ao ceticismo de comunidades e reguladores. Entenda o que muda, o impacto em licenciamento, custos e cronogramas, além do que governos e empresas devem fazer agora.
7 min de leitura