Black Forest Labs lança FLUX 3 Image Klein, 5,6B open weights
FLUX 3 Image Klein chega com 5,6 bilhões de parâmetros, open weights, recursos de edição e controle de layout, prometendo desempenho de ponta em hardware de consumo.

Danilo Gato
Autor
Introdução
FLUX 3 Image Klein é o novo modelo de imagem open weights da Black Forest Labs, com 5,6 bilhões de parâmetros e foco em geração, edição e composição multi‑referência em um único pipeline. Lançado em 15 de outubro de 2026, ele combina qualidade e eficiência em hardware de consumo, além de vir com opções prontas para execução e fine‑tuning. (bfl.ai)
A importância do tema é prática. O ecossistema de modelos visuais vive uma disputa entre qualidade, custo e controle. FLUX 3 Image Klein amplia o acesso ao estado da arte, oferece latência competitiva no API da BFL e suporte maduro para execução local com builds otimizados, o que atende startups, criadores e equipes que precisam de soberania de dados. (bfl.ai)
O artigo aborda capacidades, arquitetura, desempenho, licenciamento e cenários de uso reais, com exemplos e números extraídos das fontes oficiais e de implementações já publicadas pela comunidade.
O que há de novo no FLUX 3 Image Klein
FLUX 3 Image Klein foi lançado como open weights com dois checkpoints, base e step‑distilled, além de builds FP8, INT8 e NVFP4 desenvolvidos com suporte da NVIDIA. O modelo cobre text‑to‑image, edição e geração multi‑referência com até 10 imagens, além de controle de layout por bounding boxes, tudo em um único sistema. (bfl.ai)
Um ponto relevante está no encaixe do texto, já que o encoder textual não entra na contagem de parâmetros do gerador. A documentação da NVIDIA indica o uso do Qwen3‑VL‑4B‑Instruct como encoder separado, o que ajuda a entender por que a contagem de 5,6B se refere ao transformador de imagem. (build.nvidia.com)
Na prática, a combinação de recursos permite montar fluxos sólidos de produção. O repositório oficial já oferece código de inferência de referência, incluindo demo com controle por bounding boxes, e a página da Hugging Face disponibiliza os pesos para download imediato. (github.com)
Desempenho, latência e requisitos de hardware
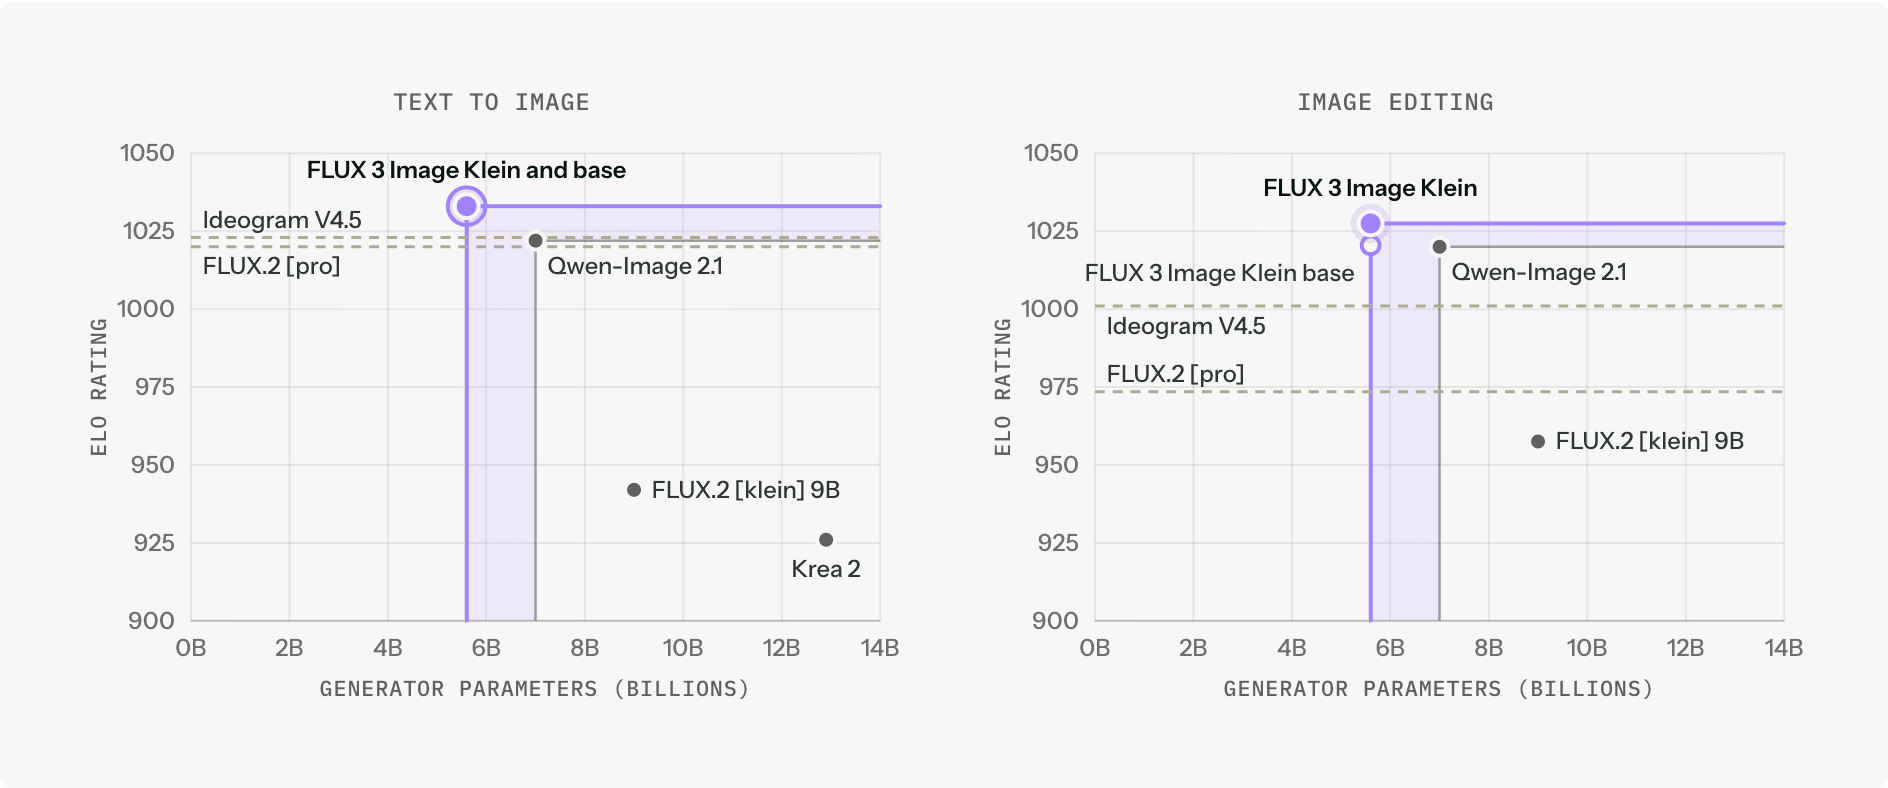
Em avaliações internas, o FLUX 3 Image Klein aparece no topo de qualidade entre modelos open weights maiores, liderando em text‑to‑image, multi‑referência e edição. Os gráficos divulgados comparam o Klein e sua base com Qwen‑Image 2.1, Ideogram V4.5, FLUX.2 pro, FLUX.2 klein 9B e Krea 2, com o Klein mantendo Elo superior mesmo com 38 por cento menos parâmetros que o FLUX.2 klein 9B. (bfl.ai)
O modelo foi otimizado para GPUs de consumo. O gerador requer cerca de 11,2 GB em BF16 e 5,6 GB em FP8. Com build INT8, roda em placas RTX com apenas 8 GB de VRAM, via ComfyUI ou Diffusers. Em termos de latência, o step‑distilled gera 1 MP em aproximadamente 4 segundos na RTX 5090 e menos de 9 segundos na RTX 4070, em ComfyUI. (bfl.ai)
No API da BFL, os gráficos de Pareto mostram o Klein como o mais rápido entre os modelos no topo de qualidade, com mediana de 4,54 s em text‑to‑image e 7,18 s em edição a 1 MP, medidos fim a fim. Esse balanço entre velocidade e qualidade importa para pipelines que precisam de custos previsíveis por imagem e throughput consistente. (bfl.ai)
Arquitetura e ecossegurança, o que sustenta a entrega
A família FLUX 3 agrega aprendizados compartilhados entre imagem, vídeo e áudio. Segundo a BFL, sinais de movimento e dinâmica vindos de vídeo e pistas contextuais de áudio ajudam o modelo a gerar imagens mais ancoradas na realidade, um indício de maior consistência física e coerência espacial. Essa abordagem se alinha com a tendência de modelos multimodais que cruzam domínios para elevar priorizações visuais e semânticas. (bfl.ai)
No front de segurança, a BFL descreve filtros no pré‑treino, técnicas de pós‑treino para suprimir comportamentos perigosos e um ciclo de red teaming interno. Antes do lançamento, os checkpoints do Klein passaram também por avaliação de um parceiro externo, a Cinder, com menos vulnerabilidades observadas que em outros open weights populares. Em mercados regulados, esses processos favorecem due diligence e reduzem riscos de compliance no uso produtivo. (bfl.ai)
Do ponto de vista de execução, a folha técnica da NVIDIA confirma a separação entre transformador de imagem e encoder textual, além da cobertura no NeMo AutoModel. Esse detalhamento facilita escolhas de runtime e explica por que benchmarks podem divergir conforme o encoder e o VAE adotados em cada stack. (docs.nvidia.com)
Ecossistema, suporte e integração desde o dia um
A BFL destaca disponibilidade imediata via API, Playground e pesos na Hugging Face, com receitas oficiais para LoRA no NeMo AutoModel e suporte a Diffusers. O repositório público traz o código de inferência, e há receitas prontas no vLLM‑Omni para integrar o modelo em servidores já existentes. O ComfyUI aparece com suporte de dia um, o que acelera testes e criação de nós customizados na comunidade. (bfl.ai)
A presença no hub da NVIDIA, incluindo um model card na plataforma NIM, reforça a seriedade do suporte, com especificações do encoder textual e orientações de execução. Para times que precisam de pacotes reproduzíveis em produção, esse tipo de documentação encurta a distância entre POC e rollout. (build.nvidia.com)
Além das fontes oficiais, a adoção comunitária é visível. Tópicos no Reddit e no ecossistema ComfyUI registram suporte nativo e discussões sobre conversões, quantizações e prazos de disponibilização dos checkpoints. Embora comunidades tragam opiniões, elas ajudam a mapear fricções reais, como dependências de upsamplers e escolhas de formato numérico. Use esses relatos como sinal de campo, sempre cotejando com os repositórios oficiais. (reddit.com)
Licença e possibilidades de uso comercial
Os pesos do FLUX 3 Image Klein chegam sob a FLUX Kommunity License. Pela comunicação oficial, há uso comercial gratuito para indivíduos e empresas com receita anual abaixo de 5 milhões de dólares, pesquisa e uso não comercial incluídos, e opções de licenças self‑hosted para organizações maiores, além do acesso via API. A VentureBeat relata o mesmo enquadramento, com foco em permitir que desenvolvedores rodem e adaptem o modelo na própria infraestrutura. (bfl.ai)
Essa política abre portas para adoção ampla em SMBs, estúdios e equipes de produto. Para empresas acima do limite de faturamento, o caminho continua claro via licenças comerciais ou consumo no API, o que simplifica a governança. Recomenda‑se revisar os termos completos e políticas de uso responsável antes do rollout. (bfl.ai)
Casos práticos, do laboratório ao produto
- Prototipagem em design e marketing. O equilíbrio entre latência e Elo facilita entregar variações com controle de layout, mantendo ritmo de iteração sem gargalos de GPU. Em operações com RTX 4070, tempos abaixo de 9 segundos por imagem em 1 MP permitem loops criativos rápidos, úteis para banners, social e thumbs. (bfl.ai)
- Edição localizada de ativos. O controle por bounding boxes evita retrabalho, já que edições ficam confinadas a regiões definidas. Em catálogos, isso reduz artefatos e preserva consistência visual entre variantes. (github.com)
- Personalização com múltiplas referências. Times de produto podem compor visuais com até 10 imagens de referência, mantendo identidade de marca ou estilo fotográfico. Isso encurta ciclos de aprovação e reduz dependência de bancos de imagem. (bfl.ai)
- Execução local e custos previsíveis. Com INT8 rodando em 8 GB de VRAM, é viável distribuir estações de trabalho para criativos e desenvolvedores, sem depender apenas de cloud. Em paralelo, há caminho para escalar no API com latência competitiva. (bfl.ai)
Como começar, stacks e boas práticas
- API da BFL. O endpoint público oferece o checkpoint step‑distilled como serviço, com prompt upsampling e pixel restoration que preserva regiões não editadas, preço divulgado a partir de 0,009 dólar por 1K image. Útil para validar qualidade e latência com o mesmo perfil dos gráficos. (bfl.ai)
- Weights na Hugging Face. Baixe os checkpoints base e distilled e use os scripts oficiais para inferência, incluindo o demo de bounding boxes. Ideal para POCs locais e pipelines customizados. (huggingface.co)
- Diffusers, ComfyUI e vLLM‑Omni. Há suporte de dia um e receitas prontas para integração. Use quantizações FP8, INT8 e NVFP4 conforme o budget de VRAM e o throughput desejado. (bfl.ai)
- NeMo AutoModel. As receitas oficiais da NVIDIA aceleram fine‑tuning com LoRA no checkpoint base, mantendo reprodutibilidade. (bfl.ai)
Boas práticas táticas: estabeleça um set de prompts canônicos para regressão de qualidade, controle seed e passos de difusão para comparabilidade, e meça custo por imagem em cenários reais, por exemplo, 1 MP para social, 2 MP para catálogo, 4K quando a fidelidade justificar. Em edição, avalie estabilidade de contornos e preservação de textura em áreas não editadas. (bfl.ai)
Reflexões e insights
A abertura de pesos em 5,6B acerta no alvo. Em vez de perseguir apenas parâmetros, o Klein foca eficiência e controle, algo que muitas equipes valorizam mais que ganhos marginais de fotorealismo. O encoder textual separado permite evoluções rápidas nesse componente, o que pode render ganhos de aderência a prompt sem inflar o gerador. (build.nvidia.com)
Outro ponto é a convergência multimodal. Ao incorporar aprendizados de vídeo e áudio, a família FLUX 3 sinaliza que coerência física e semântica se resolve melhor quando o modelo é exposto a dinâmicas temporais e eventos. A consequência prática é previsibilidade maior em cenas complexas, um requisito para publicidade, e‑commerce e editorial. (bfl.ai)
Em licenças, o recorte de receita anual abaixo de 5 milhões de dólares para uso comercial gratuito cria um funil saudável de adoção. Startups começam locais e, quando escalam, têm vias formais para licenciar. Isso reduz fricção legal e favorece roadmaps que dependem de fine‑tuning. (bfl.ai)
Conclusão
FLUX 3 Image Klein consolida uma proposta clara, qualidade de topo entre open weights, latência competitiva e suporte amplo de execução. Para quem precisa de controle de layout, edição localizada e multi‑referência, há ganhos práticos sem inflar custos de GPU. A presença em plataformas como Hugging Face e NIM, e o código oficial no GitHub, completam o pacote para adoção rápida. (bfl.ai)
O momento favorece quem quer colocar geração e edição no centro do produto. Com o Klein, há espaço para protótipos mais ágeis e rollouts previsíveis, seja em máquinas locais com 8 GB de VRAM, seja em produção via API da BFL. A recomendação é simples, validar com seus dados, medir nos prompts que importam, e escalar o que se provar consistente. (bfl.ai)
Leia também
Alibaba lança Qwen-Image-2.1-Turbo, gera 2K em 8 passos
O Qwen-Image-2.1-Turbo chega como versão acelerada open weight que gera e edita imagens em apenas 8 passos, com suporte a 2K e integração nativa com Diffusers. Veja o que muda na prática, benchmarks, configuração recomendada e como aplicar o modelo em pipelines reais.
9 min de leituraMarketing DigitalTikTok lança IA, Agentic Commerce e Ad Network na AW 2026
Na Advertising Week 2026, o TikTok apresentou IA aplicada a anúncios, Agentic Commerce e a expansão global da Ad Network. As novidades prometem transformar descoberta em vendas com automação, checkout simplificado, novas superfícies de mídia e integrações para medir impacto real.
9 min de leituraTecnologia e IAGoogle lança o Playground, criar jogos com IA sem código
O Google lançou o Playground, uma plataforma com IA para criar jogos sem código direto no navegador. Com prompts de texto, é possível gerar mecânicas, cenários e personagens, publicar na galeria da comunidade e até jogar multiplayer. Integração com o Unity Spark está em testes, abrindo caminho do protótipo à produção.
9 min de leituraTecnologia e IAMeta abre código do Muse AI SDK, crie gadgets no Raspberry Pi
A Meta abriu o Muse AI SDK e lançou o Home Link, aproximando seu agente pessoal de displays, botões e sensores com ESP32 e Raspberry Pi. Explico o que foi liberado, como começar em minutos, riscos de segurança e usos práticos no dia a dia e nos negócios, com fatos checados e links oficiais.
10 min de leitura