Google lança EmbeddingGemma 2, embedding multimodal 740M
O novo EmbeddingGemma 2 leva embeddings multimodais para o dispositivo, com 740 milhões de parâmetros, vetor único de 768 dimensões, e desempenho otimizado para buscas e RAG locais.

Danilo Gato
Autor
Introdução
EmbeddingGemma 2 é o destaque de outubro de 2026 na corrida por IA on-device. A Google DeepMind anunciou em 06 de outubro de 2026 um modelo de embeddings multimodal com 740 milhões de parâmetros, projetado para rodar direto no dispositivo, com ganhos de eficiência e qualidade que mudam o jogo para busca semântica e RAG locais. Palavra-chave, EmbeddingGemma 2. (blog.google)
Os números chamam atenção, um único espaço vetorial de 768 dimensões para mapear texto, imagens, vídeo, áudio e código, com arquitetura modular, menor uso de memória e desempenho comparável a modelos bem maiores. Essa combinação posiciona o EmbeddingGemma 2 como opção madura para produtos que priorizam privacidade, latência e resiliência offline. (ai.google.dev)
O que é o EmbeddingGemma 2 e por que importa
O EmbeddingGemma 2 é um modelo de embeddings multimodal, aberto e leve, construído pela Google DeepMind sobre a família Gemma 4, com licença Apache 2.0. Diferente de geradores como LLMs, o foco é representar dados em vetores compactos que preservam semântica entre modalidades. Essa representação unificada permite procurar um trecho de vídeo com uma consulta de áudio, ou localizar uma imagem por uma descrição em texto, tudo no mesmo espaço de 768 dimensões. (blog.google)
A novidade está no desenho para rodar integralmente em hardware de consumo. Com quantização, um Pixel 11 Pro precisa de cerca de 191 MB de RAM ativa para os pesos de texto, e aproximadamente 567 MB para o modelo multimodal completo. O contexto de 8 mil tokens processa até 5,5 minutos de áudio, dezenas de imagens e frames de vídeo, mantendo a experiência on-device. (blog.google)
Arquitetura e recursos técnicos em linguagem clara
O modelo é modular. É possível rodar apenas o componente de texto e código com cerca de 270 milhões de parâmetros, adicionar o encoder de visão para imagens e vídeo, ou completar com áudio, chegando aos 740 milhões quando tudo está ativo. Todos se alinham no mesmo espaço vetorial, o que simplifica pipelines. Para economizar armazenamento, o EmbeddingGemma 2 usa Matryoshka Representation Learning, que permite truncar vetores de 768 para 512, 256 ou 128 dimensões, reduzindo em até seis vezes o footprint do banco vetorial no dispositivo. (blog.google)
Outro ponto técnico importante, a compatibilidade com ferramentas que os times já usam. O modelo está disponível no Hugging Face e Kaggle, com suporte em bibliotecas como Transformers, Sentence Transformers, MLX, vLLM, SGLang, Ollama e LM Studio. Há integração com MediaPipe e LiteRT para apps de borda, além de guias oficiais de inferência e fine-tuning. Para armazenamento vetorial, Qdrant aparece como parceiro destacado. (blog.google)
A base de pesquisa reforça a abordagem nativamente multimodal, herdeira de técnicas da família Gemini Embedding, com espaço único para múltiplas modalidades. Esse princípio permite tarefas de recuperação e classificação cruzadas, por exemplo, encontrar em um vídeo o momento que corresponde a uma foto de referência ou a uma consulta falada. (arxiv.org)
Desempenho, benchmarks e o que realmente muda
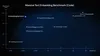
Em qualidade por parâmetro, o EmbeddingGemma 2 disputa a liderança entre modelos abaixo de 1 bilhão de parâmetros. No MTEB Code, o salto reportado sobre a geração anterior é de 9,92 pontos, de 68,76 para 78,68, um ganho prático para indexação semântica de bases de código e recuperação para agentes de programação on-device. Além disso, o modelo mantém a força em texto multilíngue e expande a qualidade em visão e áudio, superando até modelos especializados maiores em algumas métricas. (blog.google)
A eficiência prática também pesa. Com RAM ativa medida em centenas de megabytes em um celular topo de linha, o EmbeddingGemma 2 abre portas para experiências mais responsivas e privadas, como busca multimodal offline e RAG que não dependem de rede. No ecossistema Google AI Edge, showcases como Instant Media Search e Video Moments Finder exemplificam casos prontos para experimentar. (blog.google)
Casos de uso práticos para times de produto
- Busca multimodal em bibliotecas pessoais. Com o EmbeddingGemma 2, uma consulta em texto pode retornar o clipe de vídeo certo, a foto mais relevante e um trecho de um podcast, tudo ranqueado por similaridade semântica no dispositivo. Em aplicações de mídia, isso reduz latência e protege dados sensíveis. (blog.google)
- RAG local em ambientes regulados. Em setores como saúde e financeiro, gerar embeddings no aparelho evita envio de dados brutos para a nuvem, ao mesmo tempo em que alimenta um LLM de raciocínio, como Gemma 4, com contexto selecionado. O compartilhamento de tokenizador e encoder de áudio entre Gemma 4 e EmbeddingGemma 2 reduz o footprint combinado. (blog.google)
- Classificação e roteamento multimodal. Acompanhado do MediaPipe Decision Task API, o modelo vira motor de decisões que considera imagem, texto e som, útil em triagem, moderação e priorização de filas. (blog.google)
- Busca e análise de código. O ganho no MTEB Code habilita fluxos on-device para entender bases de código locais, úteis para devs em notebooks ARM ou ambientes com conectividade limitada. (developers.googleblog.com)
Como começar, um guia direto ao ponto
- Instalação. O ID do modelo em Sentence Transformers é google/embeddinggemma-2, com exemplos oficiais para Python e integração com Transformers. Para web, há suporte via transformers.js e WebGPU, enquanto no iOS é possível usar MLX. (ai.google.dev)
- On-device com Edge. Para apps nativos, o combo MediaPipe e LiteRT acelera a integração, inclusive com modelos otimizados para borda mantidos pela comunidade. (blog.google)
- Banco vetorial. Qdrant aparece como escolha compatível e leve, ideal para persistir embeddings truncados por MRL, reduzindo ocupação sem perder alinhamento semântico relativo. (blog.google)
- Fine-tuning. Há orientação de parceiros para adaptar o modelo a domínios específicos, preservando o espaço multimodal unificado. (blog.google)
Exemplo mínimo com Sentence Transformers, útil para prototipar ranking multimodal simples com texto e imagem. Ajuste os caminhos conforme seu projeto.
from sentence_transformers import SentenceTransformer, util
from PIL import Image

model = SentenceTransformer("google/embeddinggemma-2")

text_queries = [
    "cachorro correndo na praia",
    "violão acústico em estúdio"
]

images = [
    Image.open("./dataset/imgs/dog_beach.jpg"),
    Image.open("./dataset/imgs/guitar_studio.jpg")
]

# Embeddings
text_emb = model.encode(text_queries, normalize_embeddings=True)
img_emb = model.encode(images, normalize_embeddings=True)

# Similaridade
scores = util.cos_sim(text_emb, img_emb)
print(scores)
Referências oficiais incluem guias de desenvolvimento, documentação multimodal com Sentence Transformers e card do modelo, com detalhes técnicos e métricas. (developers.googleblog.com)
Boas práticas de engenharia para desempenho e custo
- Quantização e lotes pequenos. Para manter memória sob controle em celulares, prefira int8 ou int4 quando disponível, e processe em micro-lotes. Os números de RAM ativa citados para Pixel 11 Pro mostram a viabilidade prática, desde que a arquitetura do app evite cópias desnecessárias entre CPU e GPU. (blog.google)
- Vetores Matryoshka. Comece com 768 dimensões durante avaliação de qualidade e reduza gradualmente para 512 ou 256, medindo impacto no NDCG e Recall de sua tarefa. O MRL preserva ordenação relativa o suficiente para muitos cenários, economizando armazenamento e energia. (blog.google)
- Caches e reuso. Em pipelines de RAG local, cacheie embeddings de documentos e imagens, já que mudam pouco. Para queries, aplique deduplicação semântica e normalização l2 para acelerar busca.
- Indexação hierárquica. Combine listas invertidas aproximadas, como HNSW, com re-ranking semântico para equilibrar latência e precisão no dispositivo.
- Métricas alinhadas ao caso. Se o foco é código, acompanhe MTEB Code e métricas de recuperação específicas do repositório. Em mídia, priorize Recall@K em consultas cruzadas entre modalidades. (developers.googleblog.com)
Onde EmbeddingGemma 2 se encaixa no ecossistema
A família Gemma evoluiu para suportar capacidades multimodais em diferentes frentes, e o EmbeddingGemma 2 herda melhorias arquiteturais de Gemma 4, ao mesmo tempo em que aprende de linhas de pesquisa dos modelos Gemini Embedding. O resultado, um embedder nativamente multimodal sob 1B de parâmetros, compatível com ferramentas de mercado e com documentação abrangente para devs. (huggingface.co)
No ecossistema de borda da Google, o time promove demos interativas no AI Edge Gallery, como Instant Media Search e Video Moments Finder, úteis para avaliar latência real em dispositivos variados. Essas vitrines ajudam times de produto a reduzir risco antes de apostar em integrações profundas. (developers.googleblog.com)
Reflexões e insights práticos
A disputa por IA on-device entrou em fase pragmática. O EmbeddingGemma 2 avança em três frentes que importam para negócios, qualidade suficiente para o que o usuário percebe, custo operacional baixo e velocidade de entrega, já que as bibliotecas e exemplos reduzem atrito de integração. Isso permite que produtos testem hipóteses multimodais sem depender de GPUs na nuvem para cada consulta, um movimento com impacto direto em margem e experiência do usuário. (blog.google)
Há também implicações de privacidade e conformidade. Rodar embeddings no dispositivo reduz superfície de ataque e simplifica governança de dados em setores regulados. Quando necessário, a combinação com um LLM leve de raciocínio, como Gemma 4, mantém o ciclo de perguntas e respostas local, o que é útil em áreas com conectividade intermitente. (blog.google)
Conclusão
EmbeddingGemma 2 consolida uma tendência, modelos de embeddings menores, porém multimodais e eficientes, que habilitam buscas e RAG verdadeiramente locais. Com 740 milhões de parâmetros, espaço vetorial unificado de 768 dimensões, MRL para redução de armazenamento e uso de RAM que cabe no bolso, a proposta atende prioridades concretas de times de produto. As demos no AI Edge Gallery e a documentação de desenvolvedores facilitam o caminho da prova de conceito ao rollout. (blog.google)
A data de lançamento em 06 de outubro de 2026 marca um passo prático na adoção de multimodalidade no dispositivo. Para quem constrói produtos, o momento é promissor, testar com dados reais, medir latência e precisão, e escolher a configuração modular que entrega valor sem sacrificar privacidade ou custo. (blog.google)
Leia também
Google Earth AI ajuda OMS a prever Ebola, dengue e cólera
Google Earth AI e OMS uniram força para prever surtos de Ebola, dengue e cólera com semanas de antecedência. A combinação de modelos geoespaciais, dados ambientais e vigilância local melhora a precisão e permite ações proativas, da pré-posicionamento de insumos à priorização de zonas de risco.
10 min de leituraInteligência ArtificialGoogle lança agente Gemini universal para o trabalho no Workspace e Enterprise
O novo agente Gemini universal integra-se ao Gmail, Drive, Docs, Sheets, Slides, Chat e Calendar, entende contexto do negócio, orquestra vários modelos e executa tarefas longas com memória persistente. Veja o que muda para TI e para as áreas, casos reais e como começar sem surpresas em segurança, custos e governança.
11 min de leituraInteligência ArtificialAnthropic põe US$150 mi na Genesis Mission, Claude 15+
A Anthropic anunciou US$ 150 milhões para a Genesis Mission do Departamento de Energia dos EUA, levando o Claude a 15+ agências federais. Entenda o que muda para NASA, NIH e NSF, como isso se conecta ao plano “Science, A New Golden Age”, e quais oportunidades essa integração de IA abre para laboratórios e universidades.
8 min de leituraInteligência ArtificialGrok Bot ganha busca e monitoramento no X para todos os usuários, Show TLDR
O Grok Bot passou a buscar, ler e monitorar posts do X de forma nativa e disponível para todos, sem conector. A novidade acelera social listening, suporte e marketing, com análises de tendências, menções de marca e contexto em tempo real, além de resumos rápidos no estilo TLDR. Veja como aplicar, limites, privacidade e passos práticos de implementação.
9 min de leitura