Google lança Gemini 3.8 Live e Extended Thinking
Modelos de voz com raciocínio em tempo quase real chegam à API Gemini, ao app Gemini, ao Workspace e ao Search Live, unindo fluidez de conversa e execução de tarefas complexas.

Danilo Gato
Autor
Introdução
Google lançou Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking, dois modelos voltados a voz que combinam diálogo fluido com raciocínio quase em tempo real, criados para agentes conversacionais de produção. A novidade coloca a palavra chave Gemini 3.8 Live no centro das experiências por voz, do app Gemini ao Workspace e Search Live, com foco em tarefas complexas e desempenho mensurável. (blog.google)
O anúncio, publicado em 15 de setembro de 2026, detalha melhorias de inteligência, paralelismo e custo que visam escalar experiências de voz em empresas e produtos. Além da fluidez de conversa, os modelos executam ferramentas e chamadas de API enquanto continuam falando, um passo importante para agentes que precisam manter contexto e progresso sem travar a interação. (blog.google)
O que este artigo cobre, de forma prática e direta, é como esses modelos funcionam, onde se destacam em benchmarks independentes, o que muda para desenvolvedores e equipes de produto, e como avaliar casos de uso e riscos com base em dados e exemplos reais.
O que muda com Gemini 3.8 Live
A família Gemini 3.8 Live chega com duas opções. A versão padrão foca escala, custo e diálogo natural, já a Extended Thinking prioriza tarefas de alta complexidade, com raciocínio multi etapa e narração de progresso enquanto a conversa segue. Isso resolve um problema comum em voice bots, a pausa artificial durante o “pensar”, que quebra a experiência do usuário. (blog.google)
Um diferencial técnico relevante é a alternância automática entre 97 idiomas durante a conversa, recurso que reduz fricção em atendimentos globais e em fluxos com mudança de idioma por parte do usuário. Além disso, a capacidade de processar entradas visuais quase em tempo real amplia a utilidade de cenários como suporte técnico guiado por câmera, onboarding e inspeções. (blog.google)
Na prática, Gemini 3.8 Live executa tool calls e integra APIs em segundo plano. Enquanto uma ação assíncrona ocorre, o modelo segue conversando, reconhecendo o pedido do usuário, atualizando o status e entregando o resultado quando a ferramenta retorna. Isso aproxima a experiência de um assistente humano multitarefas, ideal para customer care, vendas e backoffice. (blog.google)
Resultados em benchmarks independentes
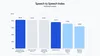
Medir qualidade em voz exige olhar além de latência e naturalidade. Em avaliações do Artificial Analysis, Gemini 3.8 Live Extended Thinking alcançou o primeiro lugar no Speech to Speech Quality Index com 82,6, além de liderar task completion nos cenários agentivos de τ-Voice com 68,6 por cento e no τ-Voice-banking da Sierra com 35,1 por cento. Em Big Bench Audio, marcou 97,7 por cento, combinando custo competitivo com desempenho de raciocínio. (blog.google)
O Artificial Analysis compõe esse índice com quatro dimensões, incluindo preferência de arena, raciocínio em áudio e taxa de sucesso em tarefas. A metodologia considera desde timing do primeiro áudio até custo por hora de áudio de entrada, e publica também a Arena Preference Elo para comparar preferência humana entre modelos em cenários do dia a dia, como agendamento. (artificialanalysis.ai)
Outra referência, o EVA-Bench da ServiceNow, mede o equilíbrio entre qualidade de conversa e conclusão de tarefas complexas, destacando o pareto entre experiência e eficácia. Nos materiais da Google, os resultados no EVA-Bench com a Live API situam os modelos no fronte desses trade-offs, úteis para quem precisa de qualidade de UX sem abrir mão de task success. (blog.google)
Disponibilidade, produtos e rollout
Segundo o anúncio, Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking começaram a ser disponibilizados no dia 15 de setembro de 2026. O rollout inclui API Gemini para desenvolvedores, AI Studio, prévia privada no Gemini Enterprise, e chegada ao Gemini Enterprise for Customer Experience. Para usuários finais, recursos aparecem no Gemini Live, além de integrações em Docs Live, Gmail e Keep para assinantes Google AI, e assistência no Search Live. (blog.google)
Para equipes técnicas, a porta de entrada é a Gemini Live API, com suporte a entrada multimodal e saída nativa em áudio via WebSockets e SDKs. A documentação destaca uso de ferramentas, orquestração e integração a pipelines em tempo real, além de guias de capacidades e exemplos de código para interações bidirecionais de baixa latência. (ai.google.dev)
No ecossistema, parceiros como Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel e Vision Agents já oferecem integrações que abstraem mídia em tempo real e infraestrutura de streaming, acelerando o caminho do protótipo à produção em voice UIs. (blog.google)

Segurança e transparência, SynthID em áudio
Transparência de conteúdo gerado por IA em voz requer marcadores robustos. A Google informa que todo áudio gerado por seus produtos de IA recebe marca d’água imperceptível com SynthID, tecnologia da DeepMind que já foi aplicada a imagem, vídeo e texto, e que foi estendida a áudio para garantir detecção de origem. (blog.google)
Posts e documentos oficiais descrevem SynthID como uma família de técnicas de marcação e detecção que embutem um sinal resistente no próprio conteúdo, permitindo verificação posterior por portais como o SynthID Detector. Em 2025 e 2026, a DeepMind detalhou avanços e estudos sobre marcação em texto, imagem e vídeo, e confirmou a expansão para áudio, alinhando-se a políticas de responsabilidade e às demandas regulatórias. (blog.google)
Debates acadêmicos recentes investigam limites, remoção e robustez de marca d’água em LLMs, algo que equipes de governança precisarão acompanhar. A implicação prática é simples, vale marcar o que é gerado e manter trilhas de auditoria, mas também validar periodicamente se as marcações resistem a compressão, remix e pós processamento no pipeline de voz. (arxiv.org)
Aplicações práticas em produto e operações
- Suporte técnico de campo. Técnicos podem abrir uma chamada com Gemini 3.8 Live no smartphone, apontar a câmera para o equipamento e relatar sintomas. O modelo acompanha o vídeo, consulta documentação via tool calls e descreve passos de diagnóstico enquanto fala, sem interromper a conversa. Quando um comando exige uma API, o agente diz o que vai executar e segue o diálogo até que a ferramenta retorne com o status. (blog.google)
- Atendimento bancário. Em τ-Voice-banking, o Extended Thinking se destacou em tarefas financeiras com ferramentas, o que sugere implementação em disputas de cobrança, renegociação e autenticação context aware. Equipes devem calibrar tempos máximos de raciocínio para controlar custos e SLAs. (blog.google)
- Vendas e qualificação. Com alternância automática entre 97 idiomas, bots conseguem lidar com leads multilíngues em tempo real. A recomendação é usar políticas de transferência para humanos quando confiança cair, e registrar raciocínio e tool calls para auditoria. (blog.google)
- Backoffice e RPA assistido por voz. A narração de progresso durante tarefas longas reduz dúvidas do usuário e melhora CSAT. Combine com limites de custo por sessão e métricas de tempo até o primeiro áudio, dois indicadores críticos na experiência. (artificialanalysis.ai)
Arquitetura, custo e medição
Projetos de voz vivem sob três tensões, qualidade de raciocínio, latência e custo. O Artificial Analysis traz quadros de custo por hora de áudio de entrada, tempo até o primeiro áudio e mapas que cruzam raciocínio com custo e velocidade. Desenvolvedores devem usar esses dados para escolher perfis, por exemplo, Live para escala e custo ou Extended Thinking para fluxos complexos. (artificialanalysis.ai)
Para instrumentar, vale expor métricas no observability stack, incluindo TTFA, duração média da conversa, taxa de interrupções bem tratadas e porcentual de tool calls concluídas. No lado de modelo, o Live API suporta WebSockets bidirecionais e SDKs GenAI, o que simplifica coleta de telemetria de sessão e correlação com logs de orquestração. (ai.google.dev)
Uma prática recomendada é configurar tolerâncias dinâmicas, se a sessão excede um teto de custo ou latência, reduzir a profundidade de raciocínio, ou transferir para o modelo Live padrão. Benchmarks como EVA-Bench ajudam a validar que essa política mantém a experiência dentro do pareto desejado. (servicenow.github.io)
Comparativos do mercado e expectativa realista
Mesmo com liderança do Extended Thinking em índices compostos, a arena de preferência humana pode oscilar conforme vozes, estilos e stacks em cascata usados por cada provedor. É por isso que a recomendação é testar cenários reais do produto, não apenas ler tabelas. A própria Arena Preference em voz pesa a escolha humana, influenciada por detalhes como backchannels, tomada de turno e como o agente lida com interrupções. (artificialanalysis.ai)
Relatos de imprensa e análises de terceiros reforçam a mensagem do lançamento, os modelos foram desenhados para produção, não apenas demos. Equipes que preferem custos menores podem iniciar com Gemini 3.8 Live, quem precisa de automação com várias ferramentas e raciocínio extenso tende a colher ganhos de task success com o Extended Thinking. A disponibilidade via Gemini API e AI Studio reduz o atrito de experimentação. (techrepublic.com)
Boas práticas de design de conversa e compliance
- Configure vozes, velocidades e estilos de resposta conforme persona de marca, mas valide se as escolhas não prejudicam compreensão, especialmente em sotaques regionais. As métricas de conversação do Full Duplex Bench lembram que interrupção, pausa e backchannels contam tanto quanto acerto factual. (artificialanalysis.ai)
- Garanta disclosures quando o agente estiver usando ferramentas sensíveis, por exemplo, chamadas a sistemas de pagamento. A narração de progresso do Extended Thinking é útil para comunicar etapas, aumente a confiança sem prometer resultados fora da política. (blog.google)
- Ative marca d’água com SynthID em qualquer saída de áudio exposta ao usuário. Registre IDs de sessão, hashes de áudio e relatórios de verificação do detector para auditorias internas e solicitações regulatórias. (blog.google)
Checklist para ir a produção
- Prototipar com Live API no AI Studio, incluindo tool calls reais do seu domínio, e medir TTFA, custo por sessão e task success. (ai.google.dev)
- Executar avaliações controladas usando τ-Voice e EVA-Bench como referência de desenho de cenários, e comparar com dados do Artificial Analysis para calibrar parâmetros. (artificialanalysis.ai)
- Habilitar SynthID no pipeline de áudio e documentar processos de verificação e resposta a disputas sobre origem de conteúdo. (ai.google.dev)
- Planejar fallback para humanos quando confiança, custo ou latência extrapolarem limiares definidos. Usar o modelo Live padrão como degrau de custo em fluxos menos críticos. (artificialanalysis.ai)
- Garantir monitoramento contínuo, inclusive pós lançamento, porque preferências de usuário variam e a Arena demonstra que ajustes finos de stack e voz mudam resultados. (artificialanalysis.ai)
Conclusão
Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking consolidam a ideia de voz como interface primária, com raciocínio quase em tempo real e integração natural a ferramentas. Os resultados em índices independentes e a chegada simultânea à API, ao app e aos produtos do Google dão sinais claros de maturidade para produção, e a palavra chave Gemini 3.8 Live já aparece como referência em projetos de agentes conversacionais. (blog.google)
Para equipes técnicas e de negócio, o caminho é pragmático, começar pequeno com cenários guiados por métrica, usar o Live onde custo e escala importam, e acionar Extended Thinking onde a conclusão de tarefas complexas faz a diferença mensurável. Com SynthID reforçando a transparência e um ecossistema de parceiros encurtando o tempo de entrega, a janela está aberta para transformar atendimento, suporte e operações com voz. (ai.google.dev)
Leia também
OpenAI lança framework para reportar desalinhamento, 6 casos
OpenAI anunciou um framework de reporte de desalinhamento e divulgou seis casos reais de comportamento inesperado em modelos recentes. O movimento eleva o padrão de transparência e oferece sinais práticos de como desenvolvedores e empresas podem detectar, investigar e comunicar incidentes de IA com governança sólida.
11 min de leituraIA e VozSpaceXAI lança Grok Voice Transcribe 2.0, 2x mais preciso pelo mesmo preço
A SpaceXAI apresentou o Grok Voice Transcribe 2.0 com promessa de 2x mais precisão pelo mesmo preço, mantendo US$0,10 por hora no batch e US$0,20 por hora no streaming. O modelo amplia suporte multilíngue, diarização e timestamps, e já aparece em rankings públicos e em casos práticos como o Loom. Veja como isso muda o jogo para suporte, reuniões e agentes de voz.
10 min de leituraTecnologia e IAGemini Notebook: chat de voz, gravação e estudo interativo
O Gemini Notebook ganhou chat de voz em tempo real, gravador de áudio no app e estudo interativo com quizzes, flashcards e vídeos curtos. As novidades, anunciadas em 15 de setembro de 2026, prometem personalizar o aprendizado e elevar a produtividade. Estudantes dos EUA podem testar o plano Google AI Pro por 12 meses.
10 min de leituraTecnologia e IAOpenAI lança Agents API beta, com Codex Harness na nuvem
A Agents API chega em beta público trazendo o mesmo harness do Codex para criar e operar agentes em nuvem com sessões duráveis, orquestração de ferramentas, subagentes e escolha do ambiente de execução. Entenda como funciona, casos de uso, integração com MCP e parceiros de sandbox, além de implicações de custo, segurança e governança.
11 min de leitura