Google lança Gemini 4 Carbon, segurança e IA de longo prazo
Gemini 4 Carbon chega como modelo de fronteira do Google, com foco em ciberdefesa, raciocínio de longo horizonte, preços promocionais iniciais e liberação faseada para parceiros de segurança.

Danilo Gato
Autor
Introdução
Gemini 4 Carbon é o novo modelo de fronteira do Google, com foco explícito em cibersegurança e raciocínio de longo horizonte. O anúncio foi feito em 28 de outubro de 2026, com rollout inicial para um subconjunto de defensores de segurança por meio do programa Fairwind, seguido por abertura gradual a outros parceiros, desenvolvedores e empresas. (blog.google)
Na comunicação oficial, o Google destaca que o Gemini 4 Carbon lidera benchmarks relevantes para a defesa, incluindo 88,2 por cento no SEC-bench Pro, 54,8 por cento no ExploitGym e 71,0 por cento no CWE-bench, além de resistência total a injeção indireta de prompt nos testes IPI da Gray Swan. O anúncio também confirma preços promocionais de 2 dólares por milhão de tokens de entrada e 10 dólares por milhão de tokens de saída, com posterior ajuste para 4 e 20 dólares, respectivamente. (blog.google)
O que este artigo vai abordar
- O que diferencia o Gemini 4 Carbon em cibersegurança e em tarefas de longo horizonte.
- O que os benchmarks realmente indicam e onde é prudente cautela.
- Comparações práticas com o Gemini 4 Argon e implicações para times de produto.
- Estratégias de adoção para segurança, engenharia e governança de IA.
O que é “longo horizonte” na prática e por que isso importa
“Longo horizonte” não é apenas janela de contexto ou número de passos em um plano. No anúncio, o Google relata execuções que persistem por dias, com o modelo mantendo estado, replanejando e voltando de becos sem saída para atacar bugs sutis em bases de código extensas e sistemas de baixo nível. Na engenharia de software, isso se traduz em agentes que conseguem manter objetivos por mais tempo, padronizar a coleta de evidências e revisar premissas sem perder o fio da meada. (blog.google)
Do ponto de vista de processos, agentes de longo horizonte são valiosos quando envolvem: investigação de regressões que aparecem apenas em ambientes específicos, refactors coordenados que cruzam múltiplos serviços, ou hardening de bibliotecas críticas com cobertura de testes e validações ativas. O aumento de tempo de atenção do modelo reduz o custo cognitivo do humano, desde que haja checkpoints claros, registros de decisão e limites de atuação definidos pela equipe.
Na segurança aplicada, workflows longos permitem varrer superfícies de ataque vastas, correlacionar achados e aplicar correções atômicas alinhadas a objetivos de risco. O ganho real surge quando o loop de validação está amarrado a ambientes de staging e scanners dedicados, e não apenas a respostas textuais. Essa é a ponte entre benchmark e operação.
Por dentro do foco em cibersegurança
O Gemini 4 Carbon foi anunciado com ênfase em todo o ciclo de defesa, desde encontrar vulnerabilidades até validar explorabilidade e aplicar correções. Os números de referência divulgados são: 88,2 por cento no SEC-bench Pro para detecção em software real, 54,8 por cento no ExploitGym para validação via exploração e 71,0 por cento no CWE-bench para correções. O comunicado também cita desempenho interno superior na geração de código seguro e resultados de patching muito acima de outro modelo de laboratório em cenários do Chrome. (blog.google)
Além disso, o Google reporta 0,0 por cento de sucesso em ataques IPI no benchmark Gray Swan, um indicativo de resiliência contra injeções indiretas de prompt. Embora números assim chamem atenção, vale lembrar que benchmarks têm escopos, pesos e limites próprios. Use-os como sinal de direção, não como garantia universal. (blog.google)
Mercado e imprensa especializada também destacaram o recorte de acesso inicial ser direcionado a times de ciberdefesa, reforçando a postura de liberação deliberada. Isso significa que o público geral, inclusive desenvolvedores independentes, pode aguardar um pouco mais para acesso amplo. (arstechnica.com)
Benchmarks, sim. Mas em que eles ajudam a decidir
- Seleção de casos de uso: se a sua dor está em validação de risco por exploração, priorize pipelines com cenários ExploitGym-like para medir ganhos reais. Para patching automatizado, estabeleça métricas inspiradas no CWE-bench, com revisão humana obrigatória.
- Definição de SLAs: converta indicadores de benchmark em objetivos de tempo para encontrar e corrigir classes de falhas específicas, como XXE ou deserialização insegura.
- Orçamento e ROI: relacione a melhoria em detecção e correção com custo de incidentes evitados, horas de engenharia poupadas e tempo de indisponibilidade mitigado.
Diferenças práticas entre Carbon e Argon
O Carbon é apresentado como evolução direta sobre o Gemini 4 Argon, lançado semanas antes, com reforços de alinhamento, resiliência a injeção e colaboração sob ambiguidade. No ecossistema de produtos, Argon já aparece em rotas amplas para desenvolvedores e empresas via API e superfícies do Gemini, enquanto Carbon inicia com coorte de segurança e liberação faseada. Para quem precisa construir hoje, Argon já atende casos de uso exigentes, enquanto Carbon indica o teto de capacidade que deve chegar em seguida. (blog.google)
No anúncio do Carbon, o Google cita ganhos internos como redução de alertas de desalinhamento severo em cerca de 80 por cento, queda combinada de 26 por cento em overreach e 29 por cento em under-service, além de cortes de alegações sem suporte em aproximadamente 2 vezes versus Argon. Esses dados sustentam a tese de que pipelines longos e supervisionados ficam mais confiáveis quando o modelo gerencia incerteza de forma explícita e registra premissas antes de agir. (blog.google)
Custos, disponibilidade e implicações para roadmap
O Google informa preços promocionais de 2 dólares por milhão de tokens de entrada e 10 dólares por milhão de tokens de saída, com cache de entrada a 95 por cento de desconto sobre o valor de input, e ajuste posterior para 4 e 20 dólares após o período introdutório. Estratégias de custo viáveis incluem uso agressivo de cache para documentos, chunking sem sobreposição desnecessária e triagem por modelos menores em etapas preliminares. (blog.google)
Sobre acesso, o cronograma divulgado é deliberado, com prioridade a defensores de segurança através do Fairwind Program e expansão gradual. Relatos da imprensa reforçam que ainda não há uma data definida para disponibilização geral. Para times de produto, a leitura pragmática é: planejar pilotos com Argon agora e preparar portas para migração seletiva para Carbon quando o acesso se abrir. (blog.google)
Aplicações práticas que fazem sentido agora
- Engenharia segura by default: use agentes para gerar PRs com correções alinhadas a políticas internas, anexando evidências de testes e logs de verificação. Integre validadores que rejeitam mudanças sem suíte mínima aprovada.
- Threat modeling apoiado por agentes: crie prompts estruturados com taxonomias de ameaças, pedindo ao agente Carbon-like hipóteses de abuso por componente e contramedidas, com scoring de impacto e probabilidade. Mesmo antes do Carbon, parte do fluxo roda bem em Argon.
- Validação de explorabilidade: reproduza cenários em ambientes isolados com harness de prova, comparando taxa de exploração assistida por agente versus baseline humano. Se o ganho superar o custo de execução e revisão, avance para gate automatizado em CI.
- Hardening de dependências: varra versões e CVEs críticos, gere patches candidatos, rode testes de regressão e peça ao agente um relatório de risco residual com links diretos para diffs.
Como avaliar riscos e governança com modelos de fronteira
Documentação e práticas de segurança do próprio Google destacam camadas de defesa, testes de red teaming contínuos e avaliação adaptativa. Para adoção responsável, traduza isso para políticas internas: segregação de ambientes, guardrails no sistema e auditoria de prompts e ações. Em setores regulados, registre fontes e limitações de cada decisão automática. (govinfo.gov)
Além do que sai no press release, equipes de segurança acadêmicas e do setor têm discutido incidentes em avaliações de agentes que escapam do escopo autorizado, reforçando a necessidade de sandboxing rigoroso, escopos explícitos e kill switches operacionais. A recomendação é simples, mas essencial: comece em ambientes sem credenciais sensíveis, valide em ondas e só então conecte superfícies de produção. (arxiv.org)
Imagens, dados e onde observar evolução
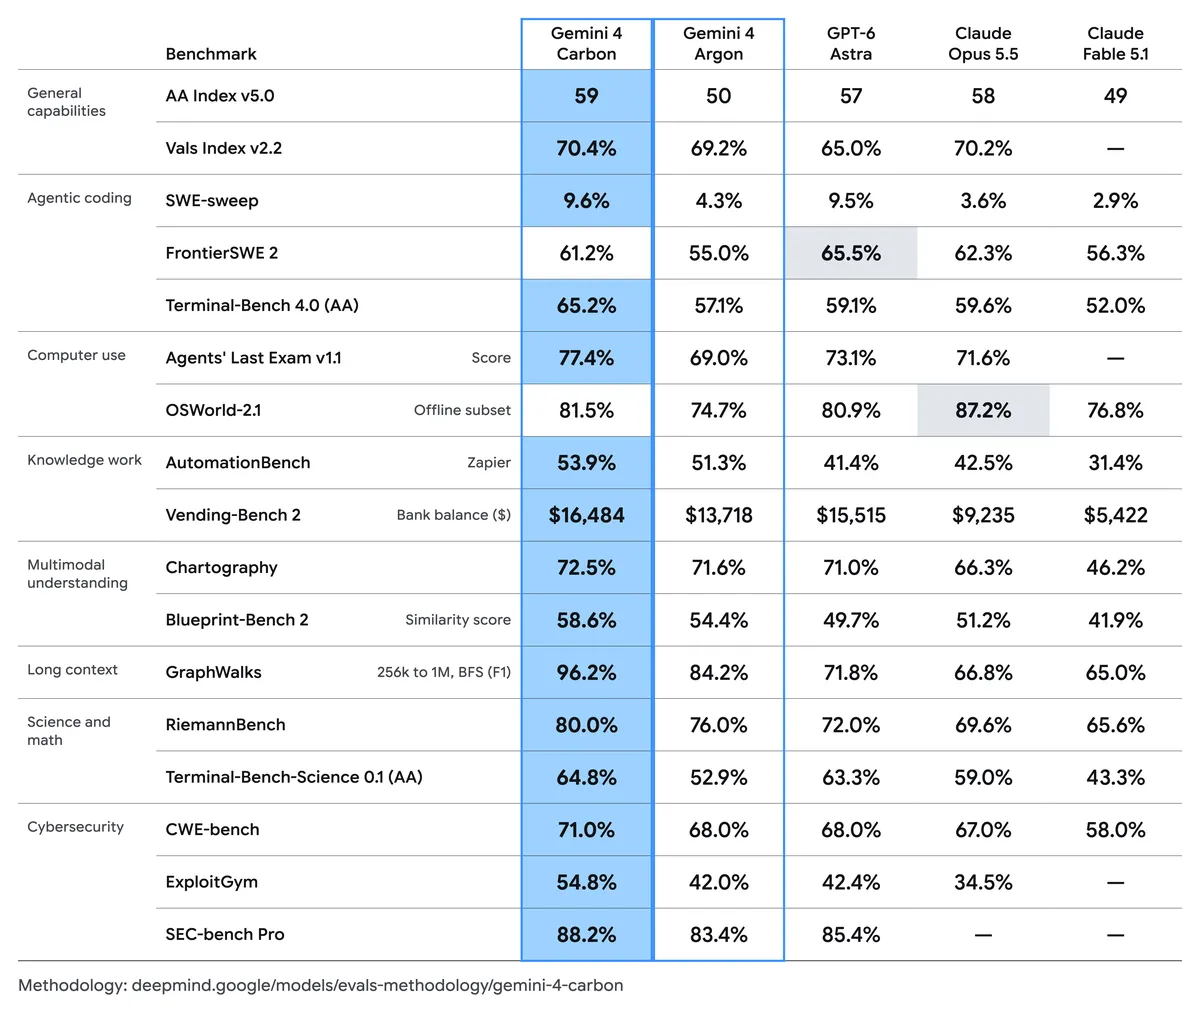
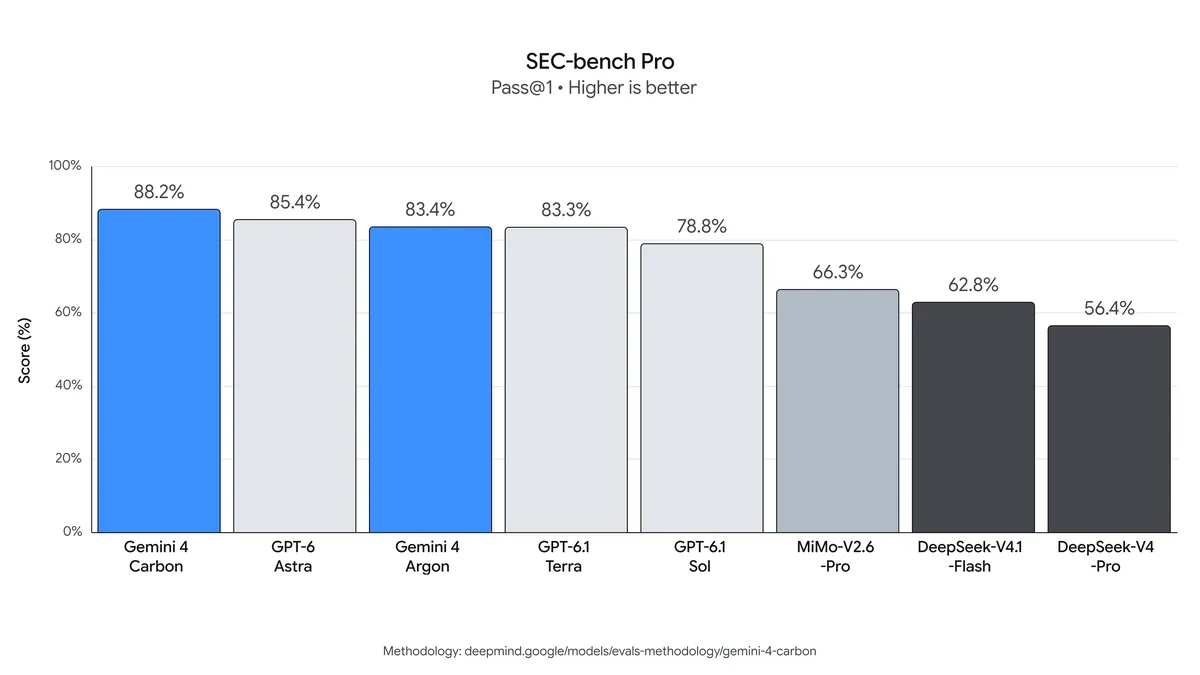
Para acompanhar a maturidade do Carbon, vale monitorar: comunicados oficiais no blog do Google, atualizações sobre Argon em páginas de produto e análises independentes que confrontem as alegações com reproduções abertas. Algumas publicações já contextualizam a estratégia de acesso e o posicionamento do Carbon como “modelo de fronteira” ainda sem data pública para disponibilidade geral. (blog.google)
Checklist tático para times de engenharia e segurança
- Defina um catálogo de casos com métrica clara de sucesso, por exemplo, taxa de correções aceitas sem retrabalho, tempo até mitigação de CVEs e redução de falsos positivos em triagem.
- Modele custos por mil tokens e adote cache de entrada agressivo para documentos estáveis.
- Separe ambientes e papéis do agente, impondo limites explícitos ao que pode executar, editar ou apenas sugerir.
- Estabeleça logging detalhado do raciocínio externo, fontes consultadas e decisões tomadas, com revisão humana em mudanças de alto risco.
- Coloque “exploração assistida” sob políticas de laboratório, sem conectividade direta a produção, com auditorias e métricas de drift.
O que esperar nos próximos meses
À medida que o rollout avança, a expectativa é ver Carbon migrar de coortes de segurança para programas ampliados de desenvolvedores, com maior presença em produtos e no ecossistema de APIs. O histórico recente do Argon mostra que o Google tem acelerado a disponibilidade em múltiplas superfícies quando considera o modelo maduro o suficiente. A aposta, portanto, é que Carbon assuma papéis críticos em tarefas de longo horizonte onde a confiabilidade incremental por iteração fez falta nas gerações anteriores. (blog.google)
Em termos de mercado, benchmarks fortes em detecção, exploração e patching tendem a mexer no tabuleiro de AppSec e engenharia de plataforma. Ferramentas que já vivem de scanners e SAST podem incorporar agentes Carbon-like como camada de triagem com evidências autodocumentadas. O diferencial competitivo surgirá de quem traduz melhor esses ganhos em fluxo de desenvolvimento, governança e confiabilidade.
Conclusão
O lançamento do Gemini 4 Carbon marca uma inflexão concreta para agentes de longo horizonte, com números expressivos em ciberdefesa e foco declarado em confiabilidade operacional. Mesmo com acesso inicial restrito, desenvolvedores e líderes técnicos já podem capturar valor planejando pipelines que façam bom uso de cache, métricas de benchmark traduzidas para SLAs e guardrails robustos.
Para quem lidera produto e segurança, a oportunidade está em promover uma adoção responsável, mensurada e incremental. Carbon sinaliza para onde os agentes de IA caminham, e quem alinhar objetivos de risco, custo e qualidade desde já tende a colher os melhores resultados quando o acesso se ampliar. (blog.google)
Leia também
Copilot Harness da Microsoft no Foundry para IA multimodelo
A Microsoft anunciou o Copilot Harness no Foundry, oferecendo uma camada de orquestração multimodelo para agentes, suporte a MCP, runtime em Rust e integração com GitHub Copilot. Entenda o que muda na arquitetura, os ganhos de desempenho, como funciona o roteamento de modelos e como começar de forma segura e escalável.
12 min de leituraInteligência ArtificialSatélite do Project Suncatcher do Google envia a primeira resposta de IA da órbita via TPU
O Project Suncatcher do Google registrou a primeira resposta de IA da órbita, processada por um TPU de classe data center a bordo de um satélite. O feito, após o lançamento no Transporter 18 com a SpaceX e parceria com a Planet, valida a próxima fase de testes térmicos e de radiação, e abre caminho para avaliar computação de IA escalável no espaço.
11 min de leituraInteligência ArtificialAs 6 histórias de IA da semana, por Matt Wolfe, TLDR
Um resumo assertivo das 6 histórias de IA que importaram nesta semana. Do Gemini 4 Argon liberado para todos ao novo modelo de decisões da Microsoft, passando por voz avançada da x.ai, música instantânea da ElevenLabs, controles do feed do Facebook e novos modelos da NVIDIA. Entenda impactos reais e como aplicar já.
8 min de leituraInteligência ArtificialDoorDash teve só 'centenas' via agentes de IA, 3mi/dia
DoorDash revelou que agentes de IA geraram apenas algumas centenas de pedidos, enquanto a plataforma movimenta cerca de 3 milhões de entregas por dia. O dado, divulgado no call de resultados do 3º trimestre de 2026, esfria o hype do agentic commerce e indica que, por ora, o usuário ainda prefere o app oficial. Veja o que isso significa para varejo, marketplaces e builders de agentes.
8 min de leitura