Google lança Gemini Decisions API, multimodal, US$0,10/1M
A nova Gemini Decisions API estreia com decisões multimodais em milissegundos, preço ultrabaixo por milhão de tokens e foco em escolhas calibradas, com confiança explícita.

Danilo Gato
Autor
Introdução
A Gemini Decisions API foi lançada em 11 de novembro de 2026 com uma proposta direta, transformar decisões de IA em uma operação rápida, calibrada e barata. A palavra chave aqui é Gemini Decisions API, um endpoint que usa o modelo Gemini Decision 1 para avaliar perguntas estruturadas de forma multimodal e em um único passe. O preço chama a atenção, US$0,10 por 1 milhão de tokens de entrada e zero custo por tokens de saída, com latência de ponta a ponta entre 150 e 250 milissegundos segundo o anúncio oficial. (blog.google)
Por que isso importa, decisões, não textos, são onde muitos fluxos produtivos emperram. Em vez de gerar respostas token por token, a API calcula probabilidades e confiança para cada pergunta, o que simplifica roteamento de modelos, checagem de políticas e scoring de conteúdo. Para equipes que precisam de respostas rápidas e confiáveis a partir de texto, imagens, áudio, vídeo ou PDFs, a proposta é reduzir custo, complexidade e variância. (blog.google)
O que a Gemini Decisions API faz de diferente
A essência está no modelo gemini-decision-1. Ele não escreve textos, ele decide. A chamada recebe um input multimodal compartilhado, com suporte a texto, imagens, áudio, vídeo e PDFs, e permite avaliar até 1.000 perguntas independentes no mesmo request. No lugar de decodificar saída autoregressiva, o modelo pontua opções em um único forward pass e retorna, para cada pergunta, a probabilidade e um score de confiança entre 0 e 1. Isso viabiliza thresholds práticos, como aceitar acima de certo ponto, recusar abaixo, e escalar casos ambíguos para revisão humana. (blog.google)
Três tipos de decisão são nativos, yes or no, múltipla escolha e rubricas ordenadas. No modo binário, a API estima a probabilidade de uma condição ser verdadeira. Em múltipla escolha, retorna a opção vencedora e a distribuição normalizada. Em rubricas, calcula um score contínuo e as probabilidades por nível. Essa estrutura cobre desde seleção de ferramenta até avaliação de qualidade de contexto, sem hacks de parsing de JSON. (blog.google)
Preço, latência e limites que mudam o jogo
Custos importam. A tarificação pública informa US$0,10 por 1 milhão de tokens de entrada, com tokens de saída a custo zero. Como a API não decodifica resposta, não há contas variáveis por saída ou custos extras por transcrição de áudio e OCR, o que simplifica previsibilidade de orçamento. Em testes do time, a latência reportada ficou entre 150 e 250 milissegundos de ponta a ponta, com computação de 50 a 100 milissegundos no núcleo do modelo. E o throughput permanece praticamente plano quando a requisição cresce de 1 até 100 perguntas, útil para lotes em produção. (blog.google)
O modelo aceita um input multimodal compartilhado, com contexto que, no comunicado, aparece como suportando grandes janelas e cargas de mídia, e permite anexar as instruções das perguntas sem replicar todo o input. Essa arquitetura significa que o custo do input base é cobrado uma vez por request, depois cada pergunta adiciona apenas seus próprios tokens de instruções e critérios, o que favorece workloads com muitas verificações contra o mesmo conteúdo. (blog.google)
Multimodalidade de verdade, com exemplos práticos
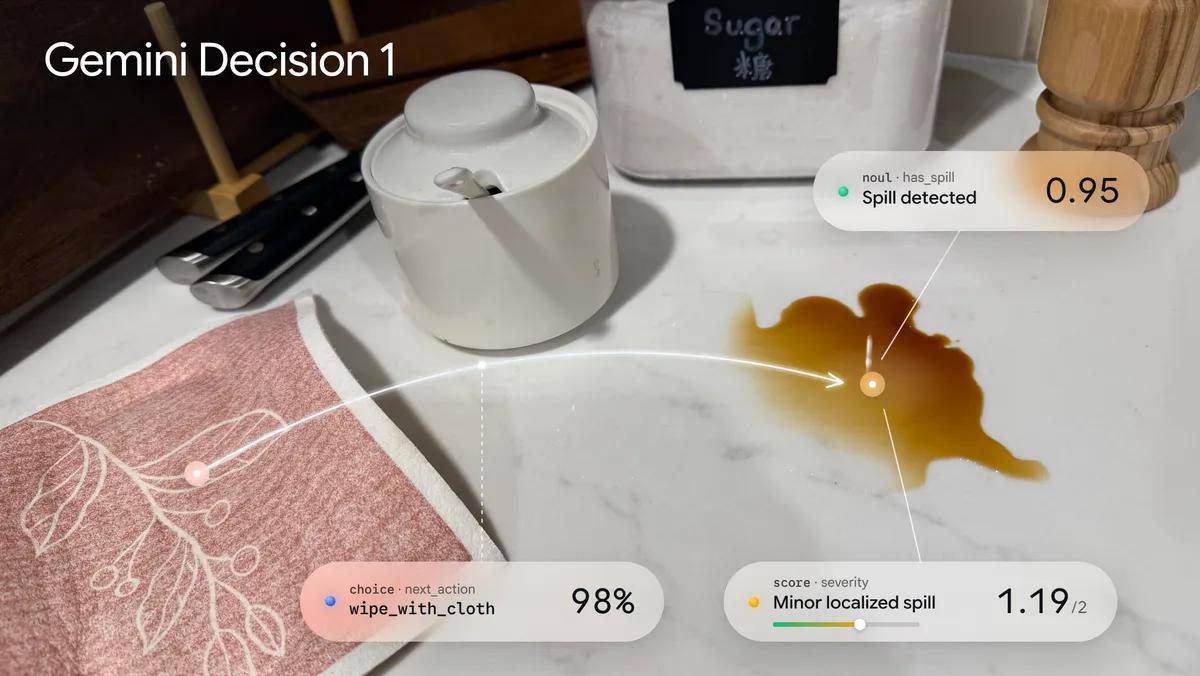
A API processa texto, imagem, áudio, vídeo e PDF em um único passe, de forma nativa. O caso didático do anúncio mostra a checagem de uma foto de copa com um bilhete de texto, avaliando simultaneamente, existe derramamento, qual ação tomar, e qual a severidade da bagunça, tudo retornando probabilidades e score. Esse padrão generaliza para compliance em documentos, triagem de chamados com gravações, verificação de políticas de conteúdo e priorização de incidentes com anexos visuais. (blog.google)
Na prática, ajustar a resolução de imagens e o sampling de frames em vídeo permite controlar detalhe visual e custo em tokens. Essa alavanca é essencial quando se avaliam centenas de perguntas contra o mesmo dossiê multimídia, por exemplo, auditoria de PDFs com fotos anexas ou detecção de eventos em videoclipes curtos. (blog.google)
Como times do Google já usam a Decisions API
O anúncio cita usos internos que ajudam a mapear padrões. O Gemini Notebook aplica a Decisions API como roteador em tempo real, classificando intenção em milissegundos e direcionando cada pedido ao nível de raciocínio e ao modelo adequados, com até 40 por cento de redução de latência em consultas rotineiras. O experimento Rapid Canvas do Stitch utiliza a API para gerar wireframes jogáveis em segundos e aceitar edições por voz ou toques quase instantaneamente, antes de exportar para o Stitch completo. E o Google Search acopla a Decisions API como camada de segurança para detectar comportamento adversarial em ferramentas MCP dentro do orçamento de latência. (blog.google)
Esses exemplos deixam claro o posicionamento, a Decisions API atua como plano de controle de baixa latência que encapsula escolhas discretas, enquanto modelos generativos mais pesados ficam reservados a tarefas que realmente exigem raciocínio longo. Em outras palavras, não é um substituto de chatbots, é o motor que decide, rápido e com confiança explícita, e depois orquestra o resto do fluxo. (blog.google)
Desempenho e calibração, o que os primeiros testes mostram
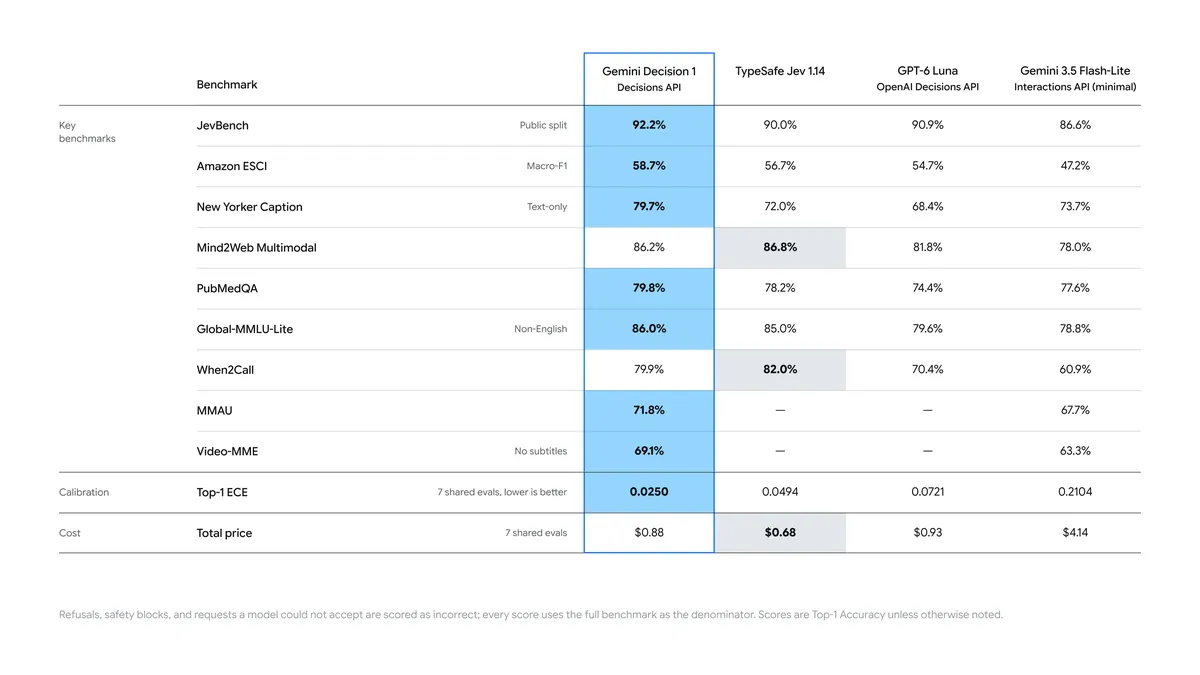
O Google destaca que o Gemini Decision 1 lidera uma bateria de benchmarks internos em roteamento de agentes, raciocínio, ranking e entendimento multimodal, com o menor erro de calibração. Materiais externos começaram a compilar resultados, e o VentureBeat aponta métricas publicadas, como 71,8 por cento versus 67,7 por cento no MMAU, e 69,1 por cento versus 63,3 por cento no Video MME, além do desempenho em AA Paperclip, onde a taxa de acertos em todos os itens de documentos completos variou entre competidores. Esses números ajudam a contextualizar onde o Decision 1 está forte e onde ainda há disputa. (blog.google)
Do ponto de vista de produto, calibração importa tanto quanto acurácia média. Uma API de decisões com probabilidade e score coerentes permite estabelecer zonas de aceitação e rejeição mais estáveis e, principalmente, uma zona cinza operacional onde humanos ou um modelo mais caro entram apenas quando necessário. O resultado é menor custo médio por tarefa e melhor UX, já que respostas fáceis saem em milissegundos. (blog.google)
Integrações do ecossistema e como começar
A disponibilidade acontece pela Gemini API dentro do Google AI Studio, com guias para Python, JavaScript e REST. O comunicado lista integrações em rollout com OpenRouter, LangChain, Vercel AI SDK, LiteLLM, Pydantic AI, Pipecat, LiveKit e OpenCode, além dos SDKs oficiais google genai. Para prototipagem, há camada sem custo no AI Studio. Para quem precisa ver para crer, há demos como Doorstep Parcels, Speed Sketch e Find the Zoo Keeper. (blog.google)
Em paralelo, vale notar a convergência entre nuvem e borda. Enquanto a Decisions API cobre o lado em nuvem com o Gemini Decision 1, o ecossistema Google tem um correlato on device no MediaPipe Decision Maker, que também formaliza perguntas do tipo escolha, booleano e rubrica, e opera em arquiteturas leves, úteis em mobile e WebGPU. Para aplicações que exigem latência ultrabaixa local com fallback para nuvem, essa combinação abre caminho para arquiteturas híbridas. (developers.google.com)
Casos de uso práticos e playbooks táticos
- Roteamento dinâmico de modelos, classificar a intenção de entrada e direcionar para o modelo mais adequado. Ganho típico, reduzir filas de modelos profundos, cortar custo e latência para tarefas triviais enquanto reserva modelos de raciocínio para casos complexos. (blog.google)
- Checagem de políticas e moderação, expressar políticas como critérios de perguntas e obter probabilidade e confiança, com thresholds por gravidade e rotas de escalonamento humano. (blog.google)
- Avaliação de contexto e ranking, pontuar blocos de contexto em pipelines RAG, priorizar evidências e decidir quando buscar mais documentos ou quando já existe base suficiente. (blog.google)
- Processamento de documentos e anexos, avaliar PDFs combinados com fotos, recibos, áudios ou vídeos curtos, e aplicar múltiplas checagens de conformidade e qualidade no mesmo request, aproveitando o input compartilhado. (blog.google)
Para cada caso, a tática central é padronizar perguntas. Defina claramente o que é sim e não, escreva critérios objetivos para cada opção na múltipla escolha e descreva níveis de qualidade na rubrica. Quanto mais objetivas forem as instruções, mais coerentes ficam as distribuições de probabilidade e os scores de confiança. (blog.google)
Boas práticas de implementação
- Estruture thresholds de decisão. Por exemplo, aceite decisões com probabilidade acima de 0,9, recuse abaixo de 0,1 e roteie a revisão humana no meio. Essa política reduz riscos, controla custo e mantém experiência ágil. Benchmarks e análises externas descrevem esse padrão de corte duplo como prática comum para modelos de decisão. (truestandard.ai)
- Otimize o input compartilhado. Carregue o dossiê multimodal uma única vez e anexe perguntas em lote. Esse padrão explora a cobrança única pelo input e mantém latência quase constante à medida que você amplia o número de perguntas. (blog.google)
- Ajuste granularidade visual. Em imagens e vídeos, regule resolução e número de frames para equilibrar detalhe útil e custo em tokens. Para tarefas de detecção simples, menos resolução pode ser suficiente. (blog.google)
- Defina caminhos de fallback. Para casos ambíguos ou sensíveis, combine a Decisions API com um modelo de raciocínio mais robusto ou revisão humana. Essa orquestração entrega o melhor dos dois mundos, velocidade e precisão onde elas importam. (blog.google)
Comparação com alternativas e visão de mercado
O nicho de modelos de decisão vem ganhando espaço justamente por cortar o custo do token de saída e entregar melhor calibração. A cobertura do VentureBeat indica ganhos sólidos em benchmarks multimodais frente a alternativas citadas nas comparações independentes, embora em alguns cenários de documentos estruturados a vantagem oscile entre concorrentes. Isso reforça a necessidade de testes com dados e critérios do seu domínio, não apenas olhar para tabelas genéricas. (venturebeat.com)
No ecossistema Google, a Decisions API funciona como peça de controle, rápida e barata, e convive com a Interactions API, voltada a fluxos generativos e agentes. Fora do Google, frameworks como LangChain, Vercel AI SDK e LiteLLM já suportam integrações, o que acelera provas de conceito. Para workloads em edge, o MediaPipe Decision Maker cobre requisitos de latência ultrabaixa on device com primitivos compatíveis de escolha, booleano e rubrica. A convergência desses caminhos mostra que decisão estruturada está virando componente de primeira classe no stack de IA. (blog.google)
Tutorial mental, da ideia ao deploy em produção
- Mapeie decisões discretas do seu fluxo. Liste perguntas que podem ser respondidas como sim ou não, múltipla escolha objetiva, ou notas em uma rubrica. Evite perguntas abertas. (blog.google)
- Construa critérios operacionais. Para cada opção, escreva descrições inequívocas que o modelo possa usar como âncoras. Em rubricas, descreva cada nível começando em 0. (blog.google)
- Normalize os thresholds. Defina níveis de confiança para aceitar, recusar e escalar. Meça o impacto de thresholds por tipo de decisão. (truestandard.ai)
- Teste multimodalidade. Combine texto com evidências visuais ou de áudio quando fizer sentido. Ajuste a resolução e amostragem para caber no orçamento. (blog.google)
- Modele o custo. Aproveite o fato de que o input compartilhado é cobrado uma vez por requisição. Agrupe perguntas e rode lotes para baixar custo médio por decisão. (blog.google)
- Planeje fallback e auditoria. Registre probabilidades, decisões e amostras, monitore calibração e crie rotas de reprocessamento com modelos mais profundos para casos de alto risco. (blog.google)
Perguntas frequentes que já surgem nos times
- Dá para usar só para texto. Sim, mas o grande diferencial é processar multimídia nativamente. Em tarefas com anexos, a API evita passar por OCR e transcrição separados. (blog.google)
- Como começam os testes. Pelo AI Studio, com camada sem custo. Há exemplos e demos prontos para experimentar sem esforço de backend. (blog.google)
- Como comparar com modelos generativos baratos. Em cargas com muitas decisões simples, a ausência de custo de saída e a latência estável tendem a superar ganhos marginais de um LLM barato decodificando JSON. O ideal é medir com seus próprios dados. (blog.google)
Conclusão
A Gemini Decisions API inaugura um caminho pragmático para decisões de IA. Com preço baixo por 1 milhão de tokens de entrada, ausência de custo por saída, latência em milissegundos e suporte multimodal, o pacote atende a um grupo enorme de problemas de produto que não precisam de texto gerado, só de escolhas confiáveis com probabilidade e confiança explícitas. A arquitetura de input compartilhado e perguntas em lote reduz custo operacional, enquanto a calibração abre espaço para políticas claras de aceitação e escalonamento. (blog.google)
Para 2026 e além, o stack de IA tende a se organizar em camadas, decisões rápidas, baratas e calibradas no plano de controle, e raciocínio profundo quando realmente houver retorno. A Gemini Decisions API se posiciona exatamente nesse espaço e, pelos primeiros sinais de adoção e benchmarks, oferece uma fundação sólida para equipes que querem transformar workflows em pipelines previsíveis de decisão. O próximo passo natural é testar com seus dados, ajustar thresholds e integrar com seu orquestrador de agentes, extraindo o melhor equilíbrio entre custo, velocidade e qualidade. (blog.google)
Leia também
Google lança Gemini 4 Hydrogen para code agentic econômico
Gemini 4 Hydrogen chega com foco em code agentic econômico e rápido. Oferece quatro níveis de thinking, janela unificada de 1M tokens, long decode e integração com Orchestrator no Antigravity. Veja como usar o modelo para codar, depurar e orquestrar agentes com melhor custo benefício.
9 min de leituraInteligência ArtificialGoogle lança Gemini 4 Hydrogen para fluxos agentic rápidos por US$1,50/M tokens
Gemini 4 Hydrogen foi lançado com foco em velocidade e eficiência para fluxos agentic. Com preço de US$1,50 por milhão de tokens de entrada e US$7,50 por saída, integra AI Studio, API, Search e app Gemini. Benchmarks indicam ganhos relevantes em tarefas de código, conhecimento multimodal e orquestração com Carbon.
9 min de leituraAndroidGemini Intelligence vai ao Motorola Signature 27 e Pixel 10
O Gemini Intelligence chegou ao Motorola Signature 27 e à linha Pixel 10 com novos recursos práticos, como Rambler, automação de tarefas entre apps, criação de widgets por prompt e assistência ao dispositivo. A expansão começou em 10 de novembro de 2026 e inclui pré-venda do Signature 27 nos EUA a partir de 19 de novembro, além de lançamentos graduais por regiões. Entenda o que muda, como ativar e por que isso importa para experiência Android.
11 min de leituraInteligência ArtificialClaude lança Whiteboards, Sheets e Data para equipes em todos os planos pagos
A Anthropic anunciou Whiteboards, Sheets e Data no Claude, com colaboração em tempo real, edição de planilhas com fórmulas, histórias de dados e conectores que abrem apps completos dentro do Claude. Os recursos chegam a todos os planos pagos, com padrões de ativação diferentes para Team e Enterprise, e prometem reduzir o vai e vem entre ferramentas, mantendo contexto, segurança e rastreabilidade.
9 min de leitura