Liquid AI lança LFM3, 2B multimodal open-weight para edge
A nova família LFM3 promete IA multimodal leve e rápida, com pesos abertos, pensada para rodar texto, visão, áudio e vídeo direto em dispositivos de borda como celulares e laptops.

Danilo Gato
Autor
Introdução
Liquid AI LFM3 chegou com uma proposta clara, levar IA multimodal de alto desempenho para dispositivos de borda com pesos abertos e footprint de 2 bilhões de parâmetros. A empresa disponibilizou modelos para texto, visão, áudio, omni e decisão, com download no Hugging Face, acesso no Playground e via API. (liquid.ai)
O anúncio destaca uma ambição prática, substituir pipelines complexos por modelos pequenos que rodam localmente com latência de milissegundos, preservando dados sensíveis e reduzindo custos de nuvem. Relatos iniciais da imprensa apontam o foco em agentes corporativos com automação de navegador, comandos de voz e reconhecimento de imagens rodando “na ponta”. (liquid.ai)
Este artigo analisa o que muda com o LFM3, como a arquitetura se organiza entre modalidades, que números de desempenho aparecem nos cards oficiais, onde o licenciamento se posiciona e que casos de uso fazem mais sentido agora, sem promessas exageradas, só o que está nos materiais públicos.
O que é o LFM3 e por que importa
O LFM3 é uma família de modelos open-weight de classe 2B, desenhada para rodar em celulares, laptops e outros dispositivos de borda. A página de modelos da Liquid descreve o objetivo como baixa latência, resiliência on-device e implantação consciente do hardware, com entradas e saídas multimodais e um pipeline fim a fim em um único modelo. (liquid.ai)
A família inclui um backbone de texto de 1,7B parâmetros para agentes e aplicações especializadas, variantes de visão com vídeo, modelos de áudio para ASR e TTS, um modelo omni que combina texto, imagem, vídeo e áudio, além de modelos de decisão que retornam probabilidades em um único forward pass. Os cards no Hugging Face e materiais recentes mencionam explicitamente LFM3-1.7B, LFM3-VL-2B e LFM3-Omni-2B entre outros. (huggingface.co)
A imprensa especializada reforça o posicionamento, modelos compactos para trazer mais trabalho corporativo para hardware controlado pela empresa, com indícios de que o menor modelo de texto supera rivais maiores em tarefas selecionadas de automação de navegador e uso de ferramentas. Naturalmente, são resultados reportados pela empresa, então convém validar cada cenário em ambiente real. (venturebeat.com)
Arquitetura tri híbrida e modalidades
Nos cards oficiais, o LFM3-1.7B aparece como base para pós treino orientado a agentes, com janela de contexto de até 256K tokens e suporte a rastros agentic, chamadas de ferramentas e raciocínio. A família então se ramifica em texto, visão, áudio, omni e decisão. O LFM3-Omni-2B integra tudo isso de forma “any to any”, aceitando texto, imagem, vídeo com ou sem trilha sonora e áudio, e respondendo em texto ou fala, com 2,17B parâmetros e vocabulário de 128k tokens. (huggingface.co)
O card do Omni detalha entradas e saídas, contexto de 32K, processamento de vídeo a 2 fps, e uma pilha que inclui um codificador de áudio causal, encoder de visão proprietário e um codec próprio para fala em 24 kHz. Essa abordagem evita costurar múltiplos modelos de ASR, VLM, LLM e TTS, trocando a complexidade de orquestração por um único checkpoint. (huggingface.co)
Para visão, o LFM3-VL-2B foi treinado com uma sequência de estágios, visão mid training, SFT multimodal, RL de visão e uma destilação on policy multi domínio. O card inclui gráficos de desempenho no edge e em GPU de datacenter, junto com uma tabela grande de benchmarks normalizados em 62 conjuntos de visão. (huggingface.co)
Vale notar a continuidade evolutiva, a Liquid vinha do LFM2 e LFM2.5 com foco em edge, e publicou relatórios técnicos e apresentações que ajudaram a posicionar a estratégia de modelos pequenos, janelas longas e releases com pesos abertos e toolchains populares de inferência. O LFM3 herda e amplia esse foco para multimodalidade ampla. (arxiv.org)
Desempenho e benchmarks no edge
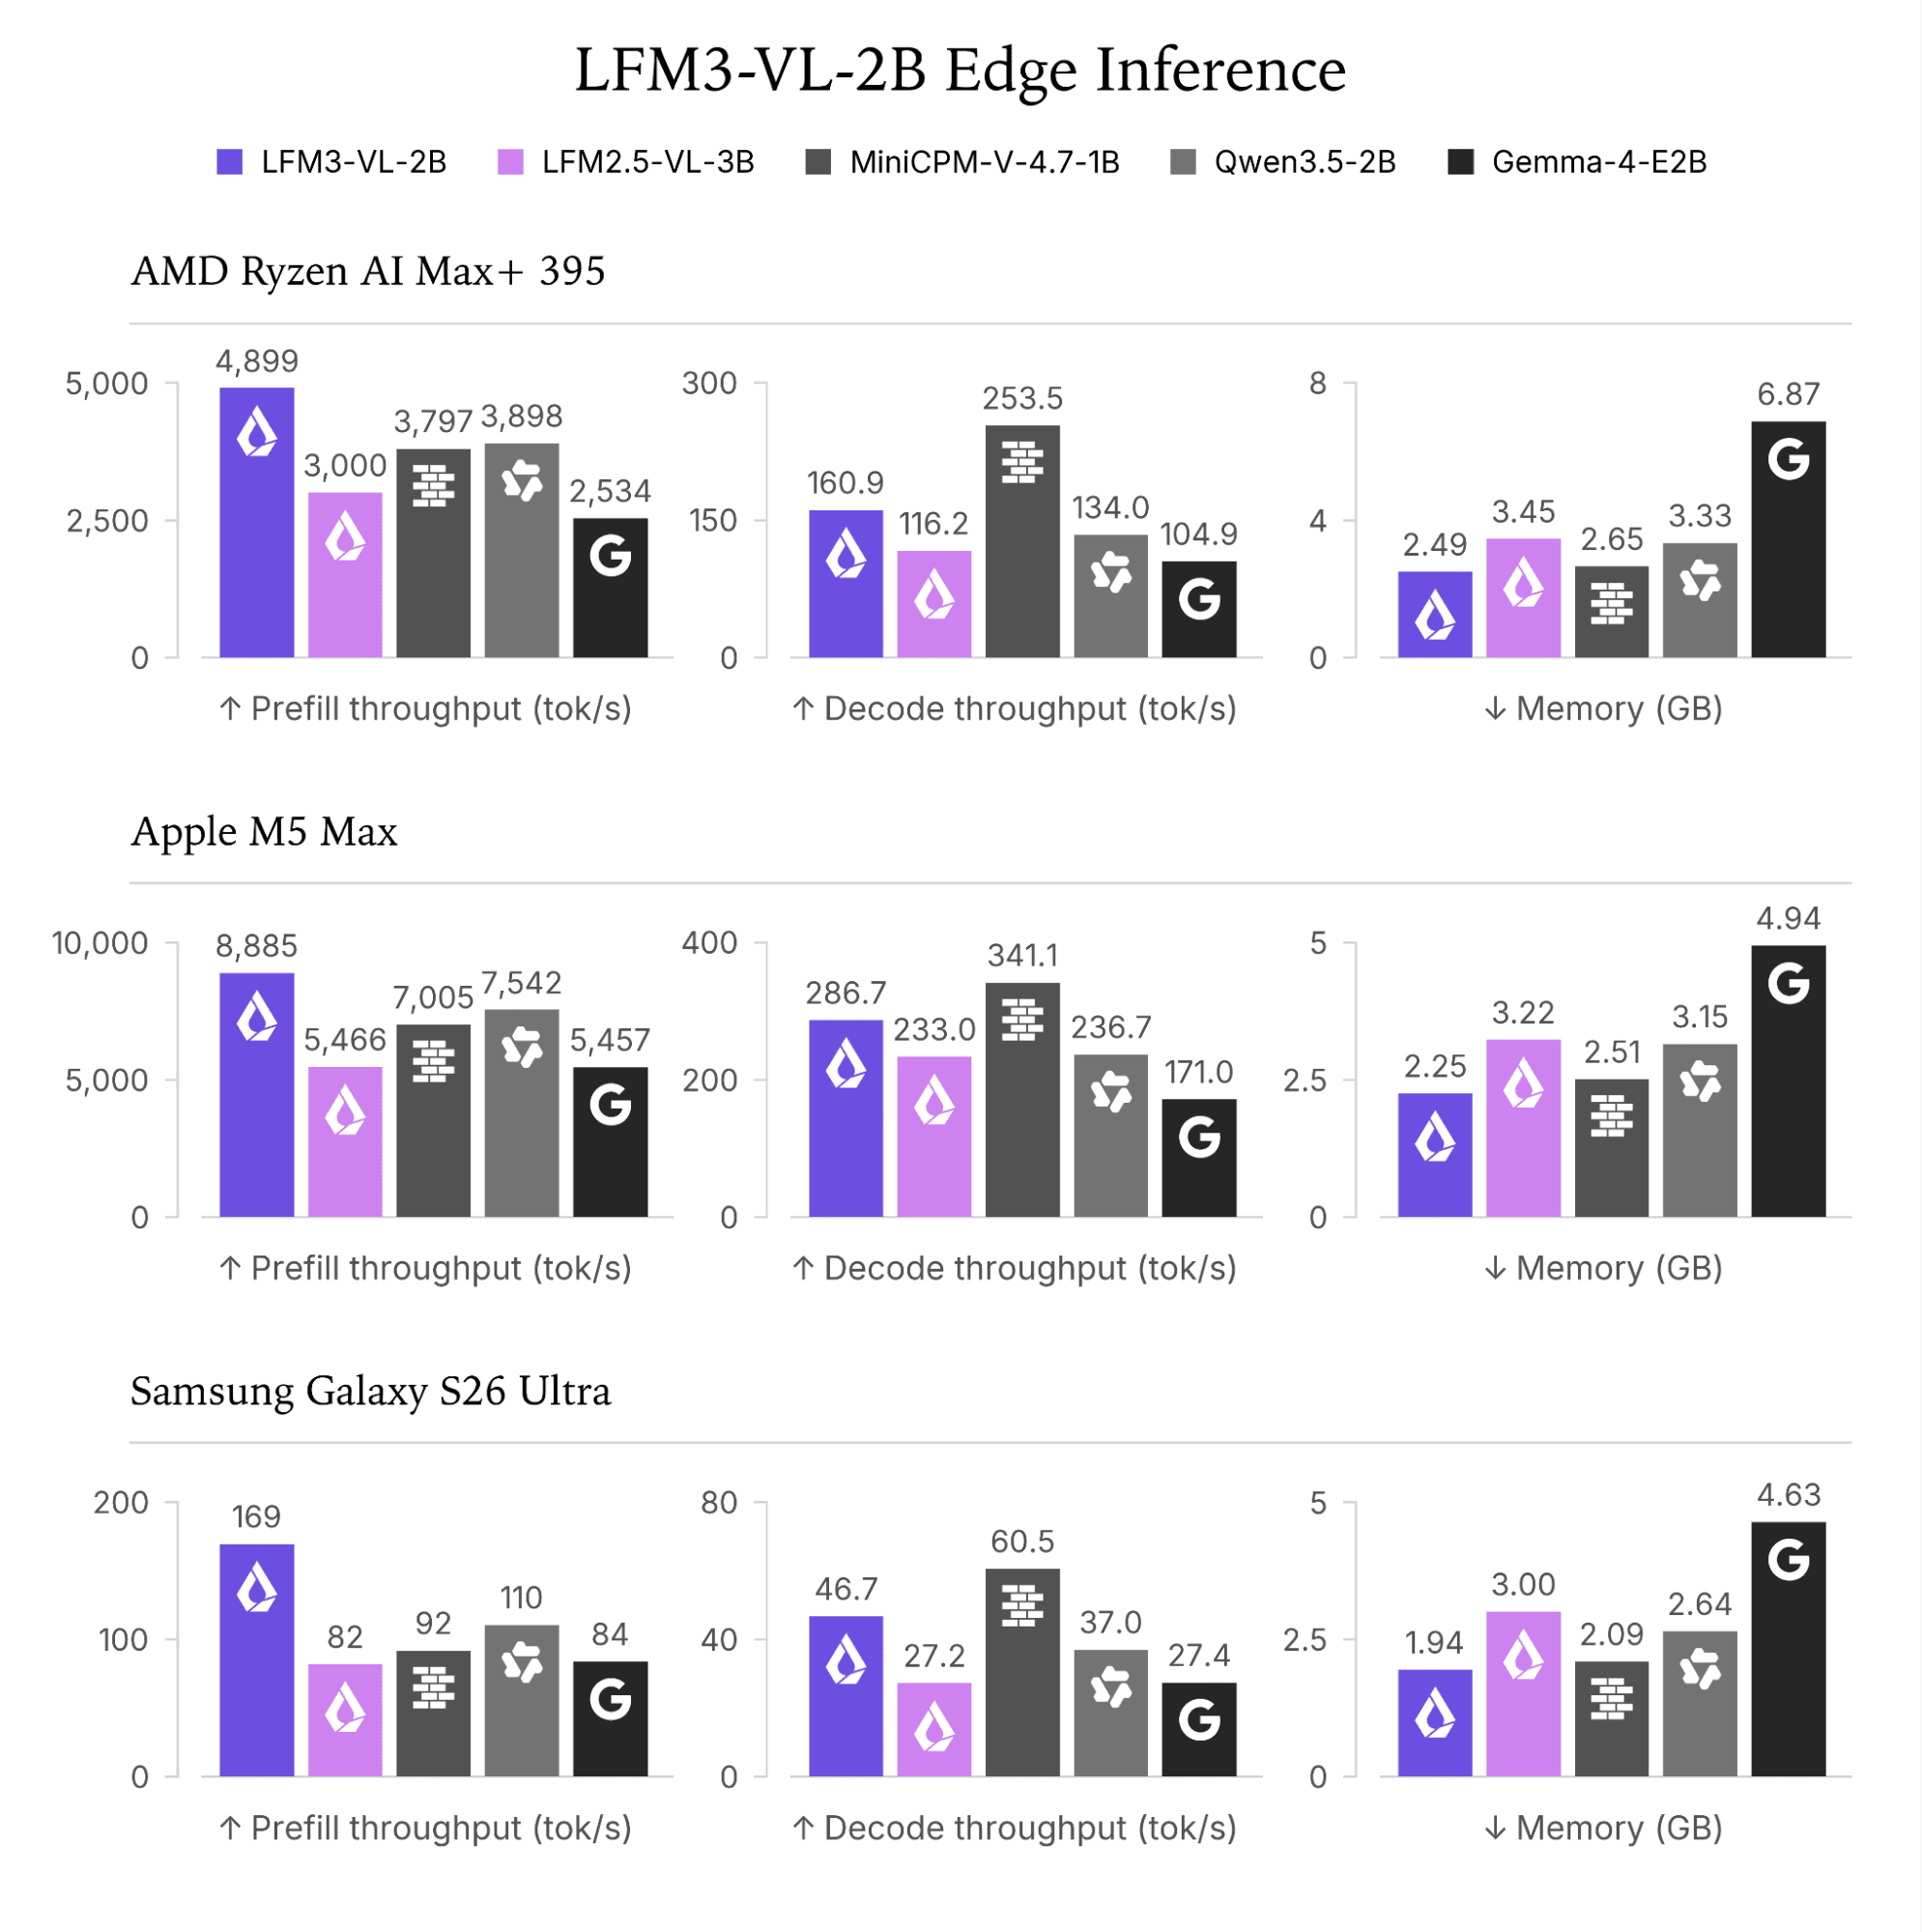
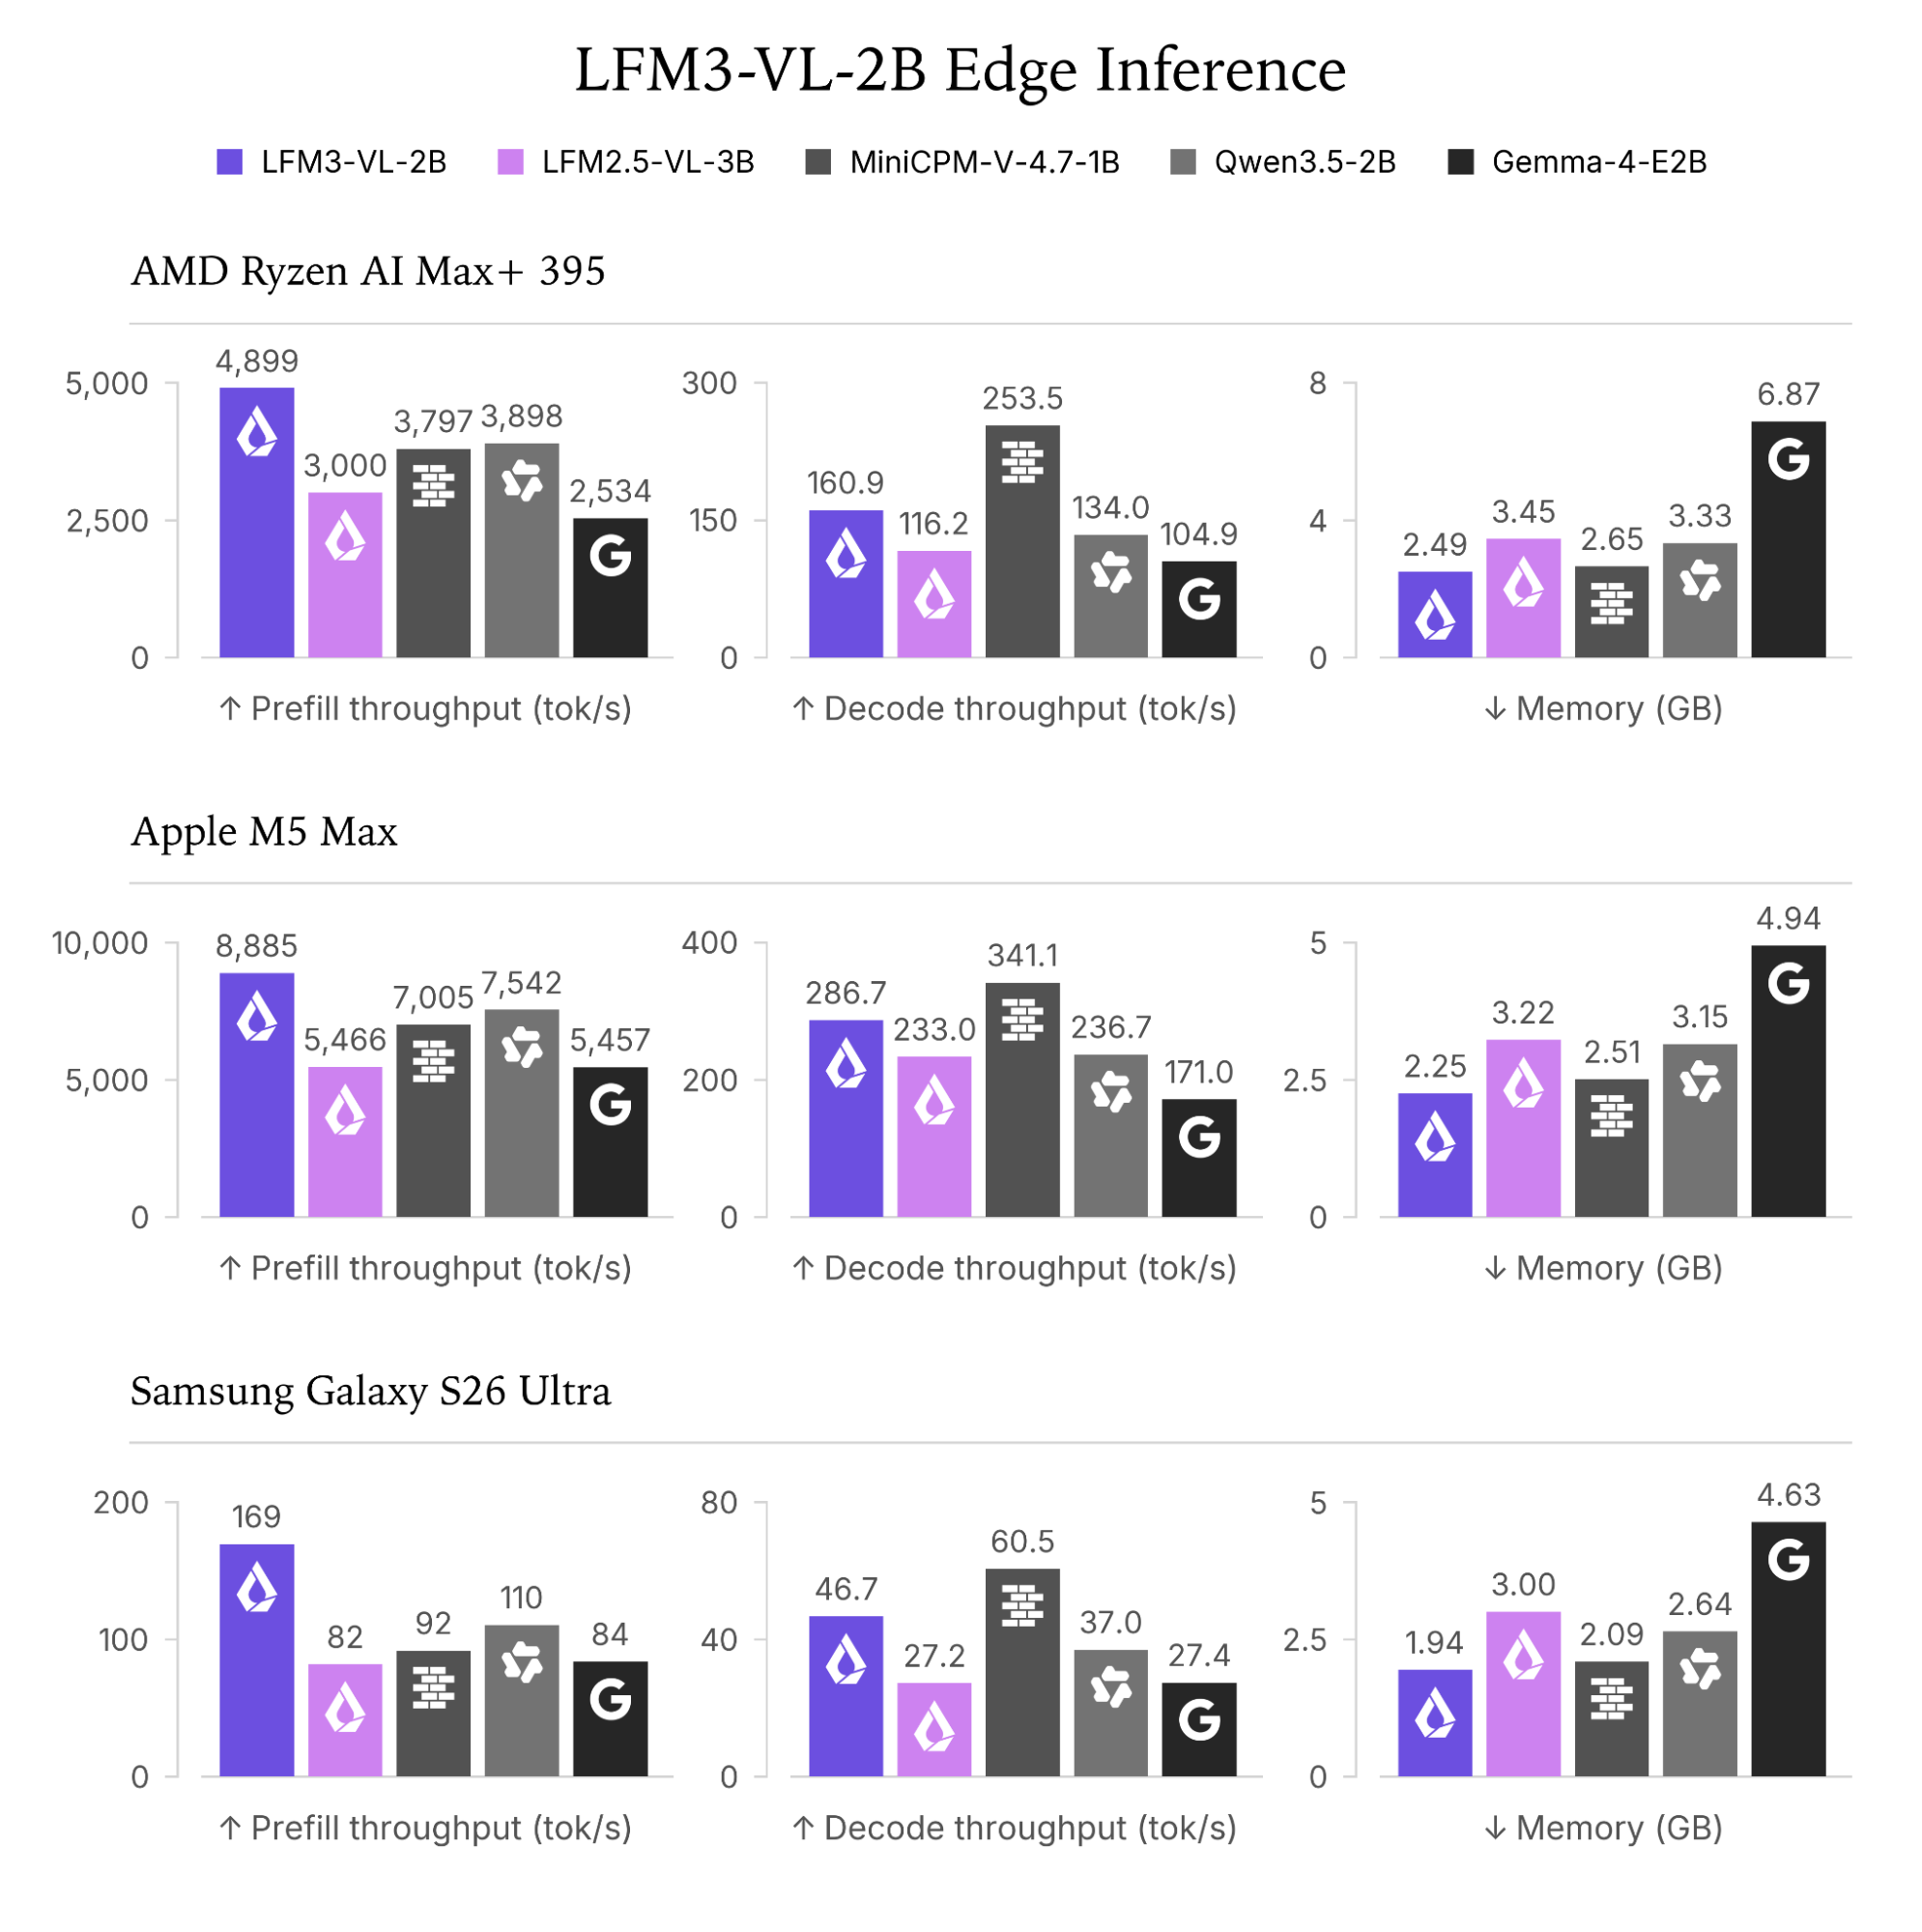
Os gráficos do LFM3-VL-2B indicam throughput de prefill mais alto e menor uso de memória que pares do mesmo porte, em três dispositivos, AMD Ryzen AI Max+ 395, Apple M5 Max e Samsung Galaxy S26 Ultra, todos rodando em llama.cpp com quantização Q4_0 e mmproj em F16. A configuração de teste incluiu uma imagem de 512 por 512 e 1.024 tokens de texto, gerando 256 tokens. (huggingface.co)
No ambiente de GPU para visão, há um gráfico indicando que em uma única NVIDIA B300 o LFM3-VL-2B produz mais de 12 mil tokens por segundo a 1.024 requisições concorrentes, superando os modelos comparados. O detalhe metodológico menciona BF16 e SGLang na versão listada. Como todo benchmark de fornecedor, convém reproduzir com prompts, quantizações e lotes equivalentes ao seu uso real. (huggingface.co)
O modelo omni também publica matrizes comparativas em tarefas multimodais, incluindo AV compreensão com vídeo e áudio, e resultados de ASR e TTS. Há cenários em que pares maiores mantêm vantagem, especialmente em benchmarks de visão de escopo amplo, mas o Omni 2B aparece competitivo em tarefas combinadas de imagem e áudio e em benchmarks de fala, considerando o tamanho. Esses números foram medidos pela própria Liquid, portanto a recomendação é usar como referência inicial e validar no seu pipeline. (huggingface.co)
Casos de uso práticos no device
A cobertura jornalística resume bem as apostas, agentes corporativos rodando localmente, automação de navegador, comandos de voz e reconhecimento de UI e documentos, tudo sem enviar dados sensíveis para a nuvem. Para times de TI, isso reduz superfícies de risco e custos de latência de ida e volta, especialmente em fluxos com áudio e vídeo. (venturebeat.com)
No card de visão, há segmentos específicos como OCR, gráficos, grounding e entendimento de GUI. Isso aponta para uso em backoffices, validação de documentos, inspeção visual e suporte a operadores, onde cada milissegundo e cada watt contam. Em mobilidade, o recorte multimodal com vídeo a 2 fps facilita criar copilotos em tempo real para manutenção de campo, RPA visual e interpretação de telas de sistemas legados. (huggingface.co)
O Omni 2B merece atenção quando a experiência exige “conversa com fotos, vídeos e áudios”. Um uso simples, fotografar um painel, fazer uma pergunta por voz e ouvir a resposta, sem montagem de quatro modelos distintos. Em idiomas, o card lista suporte a múltiplas línguas para texto e fala, incluindo português, o que reduz fricção em protótipos comerciais no Brasil. (huggingface.co)
Modelos de decisão, divulgados semanas antes, mostram outra trilha, em vez de gerar texto, retornam probabilidades em um passe. Isso é útil para roteamento, classificação e controle, por exemplo, para decidir se um caso vai para um humano, se um passo do fluxo deve continuar ou se uma ferramenta específica precisa ser chamada. É uma alternativa eficiente quando a saída textual não é necessária. (reddit.com)
Como começar, do laboratório ao piloto
A Liquid lista acesso às versões base e pós treinadas no Hugging Face, no Playground e via API. Para execução local, os cards citam suporte a BF16 em GPU, quantizações GGUF para CPU e GPU e integração com frameworks como llama.cpp e SGLang. Isso facilita pilotos rápidos no desktop do desenvolvedor e migração para produção em dispositivos alvo. (liquid.ai)
Alguns pontos práticos para pilotos em edge com LFM3, começar por prompts e janelas de contexto que caibam na capacidade local, preferir quantizações Q4 ou Q5 para equilíbrio entre qualidade e memória, testar lotes pequenos para latência de fala natural no Omni, e medir aquecimento e consumo em cenários reais de câmera, microfone e rede. Os gráficos de edge no card de visão ajudam a estabelecer metas iniciais de throughput e memória. (huggingface.co)
Para times que já vinham avaliando LFM2 e LFM2.5, a migração tende a ser incremental. Há documentação e guias comunitários que mostram como rodar variantes anteriores com WebGPU e toolchains locais, o que serve de referência para o LFM3. Experiências relatadas em fóruns indicam que modelos pequenos exigem curadoria de instruções e, dependendo da tarefa, um pós treino leve para o domínio. (insiderllm.com)
Licenciamento, limites e governança
Os cards mais recentes exibem a licença LFM Open License v1.0. Cobertura independente aponta que o texto da licença nas linhas de LFM anteriores permite uso comercial, porém com um teto de receita anual para uso sem acordo adicional, citado como até 10 milhões de dólares por algumas análises. Para empresas maiores, a recomendação é contatar a Liquid para termos comerciais. Leia e confirme a versão que acompanha cada checkpoint do LFM3 antes de distribuir. (huggingface.co)
Open weight não é sinônimo de open source. O acesso aos pesos facilita POCs, auditoria técnica e ajustes finos, porém obrigações contratuais e de marca permanecem. Em ambientes regulados, registre versões de checkpoint, quantizações e conjuntos de dados de testes, e estabeleça trilhas de auditoria para prompts e saídas, especialmente quando houver geração de fala. (en.wikipedia.org)
Como o LFM3 se posiciona no cenário multimodal
Literatura e releases recentes mostram uma tendência de integrar modalidades em um único backbone, reduzindo dependência de encoders externos como CLIP e simplificando a engenharia de produto. Trabalhos acadêmicos da linha Liquid apontam economia de treino quando se reutiliza fundações linguísticas, mantendo desempenho multimodal competitivo. O LFM3 operacionaliza esse caminho no corte de 2B, equilibrando custo e latência. (arxiv.org)
Comparações com modelos maiores ainda favorecem os gigantes em tarefas de raciocínio profundo e benchmarks generalistas, mas a proposta aqui é cobertura suficiente por watt e por dólar em edge. Com o Omni 2B, fica mais factível construir experiências de voz multimodal em apps móveis e softwares de campo. O trade off deixa de ser entre “ou nuvem poderosa ou nada” e passa a ser “quanto dá para fazer bem no device e o que fica para a nuvem”. (huggingface.co)
Conclusão
O LFM3 marca um passo concreto para IA multimodal prática no edge, com variantes focadas, disponibilidade ampla e documentação que facilita POCs. Há ganhos de throughput e memória reportados nos cards oficiais e uma narrativa consistente com a trajetória da Liquid em modelos pequenos com pesos abertos. Para quem precisa de agentes com visão, fala e automação local, vale um piloto direcionado. (liquid.ai)
A recomendação final é pragmática, escolher a variante pela tarefa, validar métricas com seus dados e dispositivos, e fechar questões de licença cedo. Se o objetivo é diminuir latência, preservar dados e manter controle operacional, o LFM3 abre espaço para resultados rápidos em celulares e laptops, com a flexibilidade de escalar para GPU quando necessário. (liquid.ai)
Leia também
Meta lança Waddle World, app de diário com IA para pets nas Filipinas
Waddle World é o novo app da Meta que transforma conversas rápidas em entradas de diário com doodles gerados por IA, embalado em um bichinho virtual 16 bit. Disponível apenas nas Filipinas, o app sugere uma estratégia mais ampla da empresa para popularizar agentes de IA com apelo lúdico e mascotes cativantes.
10 min de leituraTecnologiaApple lança iMac com chip M6, 5x mais rápido em IA que o M4
O novo iMac com chip M6 promete até 5x mais velocidade em IA que o M4, além de CPU e GPU mais rápidas, Wi-Fi 7, Bluetooth 6 e SSDs com leitura e gravação até 2x mais velozes. Com macOS 27 e Siri AI, a aposta é elevar fluxos de trabalho criativos e produtividade no all‑in‑one de 24 polegadas. Veja dados oficiais, preços, datas e o que muda na prática.
9 min de leituraInteligência ArtificialGenie 4 da DeepMind, simulação tempo real com áudio e física
Genie 4, anunciado pela Google DeepMind em 27 de outubro de 2026, avança a simulação de mundo com interação em tempo real, áudio nativo e física mais convincente. O modelo estreia em pesquisa com testadores de confiança e deve chegar ao Project Genie, assinantes Google AI Ultra e parceiros da Gemini API. Entenda capacidades, limitações, casos de uso e impactos para jogos, entretenimento e prototipagem.
10 min de leituraInteligência ArtificialMicrosoft MAI Image 2.7 lançado, 2º na AA e 3º no Arena
MAI Image 2.7, novo modelo de edição de imagens da Microsoft, estreou em 27 de outubro de 2026 no topo do mercado. Ficou em 2º na Artificial Analysis e em 3º no Arena Edit. O resultado indica melhorias reais em controle de cena, estilo, iluminação e edição de texto em imagens, com impacto direto para criadores e marcas.
10 min de leitura