MiniMax lança H3-Image, 4K com pesos abertos, 16 MP em 10 s
H3-Image chega com pesos abertos, saída 4K em cerca de 10 segundos e até 16 imagens de referência, unindo velocidade, qualidade e aderência ao prompt para fluxos criativos e produtos.

Danilo Gato
Autor
Introdução
MiniMax H3-Image é um gerador de imagens 4K com pesos abertos que promete 16 MP em cerca de 10 segundos, combinando velocidade, qualidade e forte aderência ao prompt. A palavra-chave MiniMax H3-Image sintetiza um movimento relevante, a abertura de pesos em um modelo de imagens de alto nível e com foco explícito em execução rápida para 4K. O anúncio oficial, publicado em 11 de novembro de 2026, detalha ganhos de velocidade de até 5 vezes versus alternativas mainstream e reforça o suporte a até 16 imagens de referência. (minimax.io)
O contexto importa porque 4K nativo elimina pós-processamento pesado, reduz retrabalho e acelera ciclos de avaliação visual. O lançamento cobre geração por texto, edição a partir de imagens de referência e integração por API, MiniMax Code e Hailuo AI, com política de preços agressiva de estreia em 4K. O pacote também inclui gráficos de latência e exemplos de custos por resolução. (minimax.io)
Este artigo aprofunda o que o H3-Image entrega em arquitetura, desempenho, recursos e custo, compara com dados independentes e oferece caminhos práticos de adoção em produtos, times criativos e stacks locais.
O que o H3-Image é e por que pesos abertos importam
H3-Image é um modelo open-weight de geração e edição de imagens baseado na família H3, com saída nativa próxima de 16 MP em qualquer razão de aspecto, sem precisar de upscaler, com apenas 6 passos de amostragem. O repositório oficial descreve tarefas, formatos de saída e limites, incluindo suporte a 1 a 10 imagens por requisição e até 16 referências. (github.com)
A decisão por pesos abertos expande pesquisa, customização e implantação empresarial, reduz lock-in e habilita auditoria técnica. O post técnico da MiniMax destaca a meta de aproximar a qualidade do real, reforça a aderência a instruções e posiciona o H3-Image como um avanço para o ecossistema aberto, com ganhos conjuntos de dados, RL, redução de passos e otimizações de deployment. (minimax.io)
Em especificações, o README do projeto detalha a arquitetura, incluindo encoder de texto Qwen3-VL, VAE de imagem e um Diffusion Transformer denso, com 33,1 bilhões de parâmetros. A documentação também lista tamanhos típicos de 16 MP, como 4096x4096 para 1:1 e 5472x3072 para 16:9. Esse nível de clareza técnica facilita sizing de infraestrutura e planejamento de latências. (github.com)
Desempenho, latência e o que esperar no mundo real
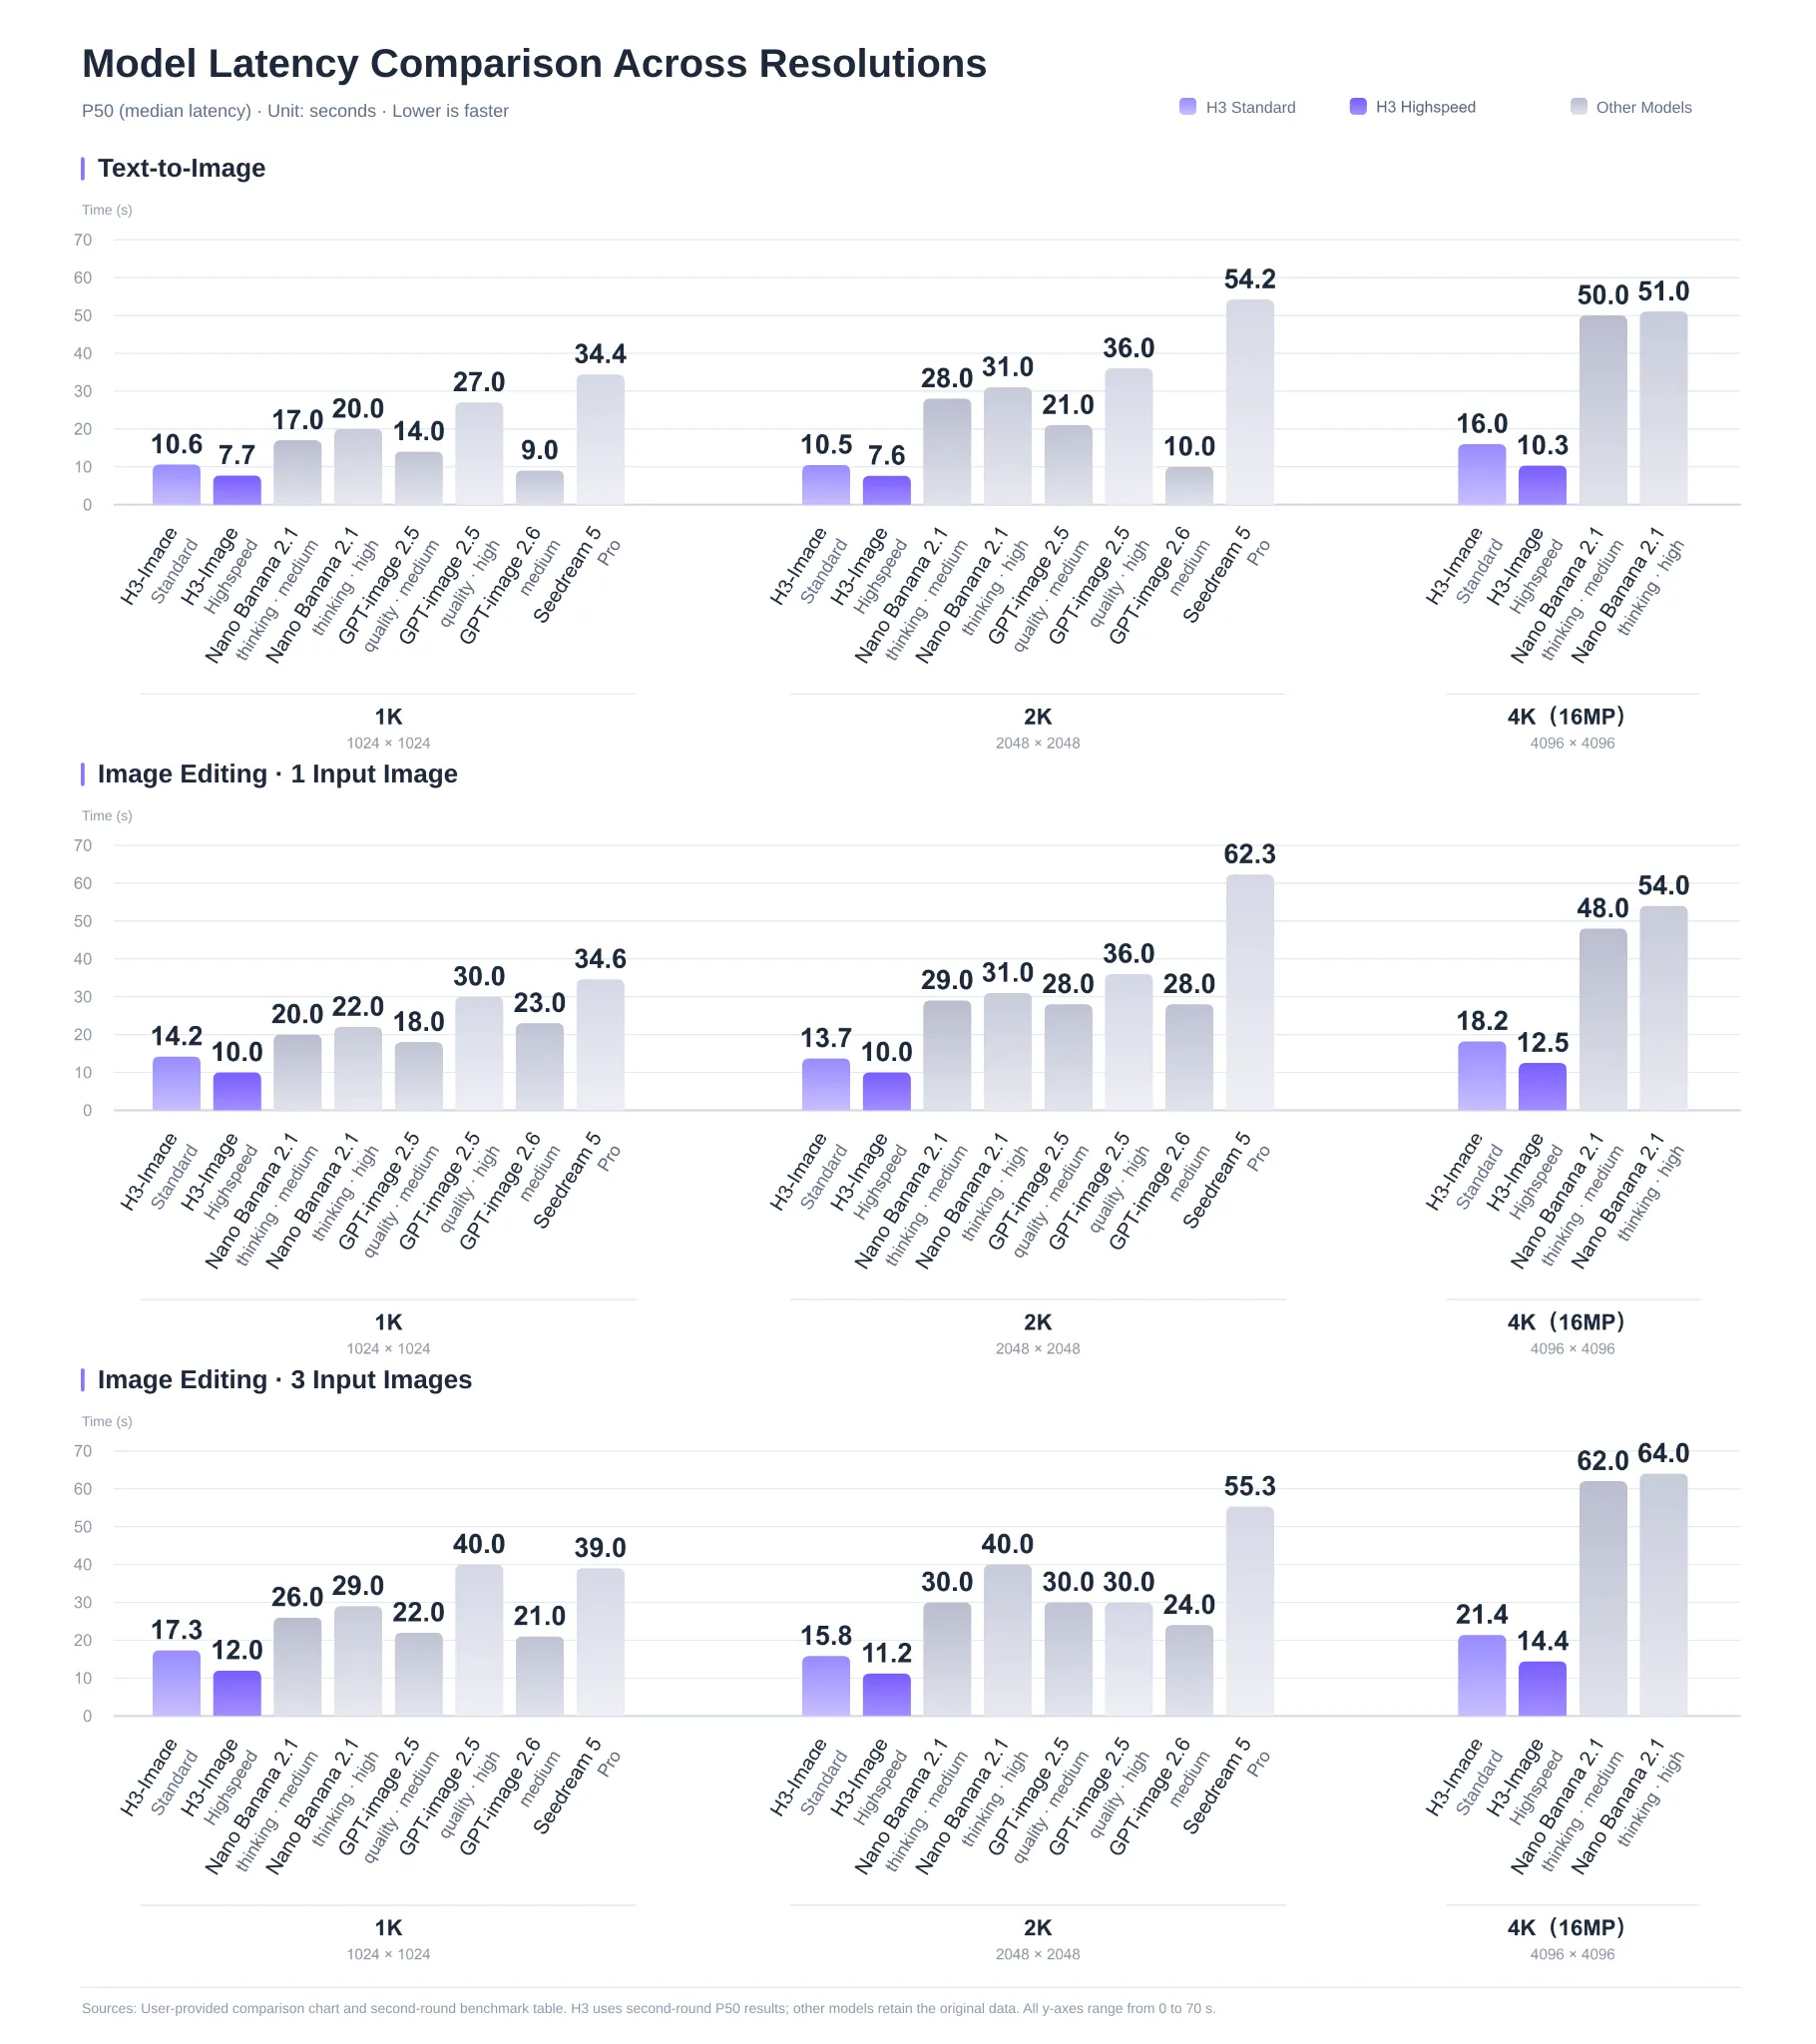
O post oficial apresenta um comparativo de latência que sustenta a tese do 4K em menos de 10 segundos, com ganhos de até 5 vezes sobre alternativas comuns. A MiniMax reporta dois modos, Standard e Highspeed, com 1,5 a 2 vezes e 3 a 4 vezes de aceleração respectivamente em relação ao mainstream. Esses números visam o uso cotidiano, não apenas benchmarks. (minimax.io)
Relatos independentes variam conforme hardware e rota de execução. O Oeneo AI publica tempos medianos de geração e edição, com medições P50 na casa de 10 a 16 segundos para 4K dependendo do modo, e documentação das entradas aceitas e limites de tamanho por lado. Esses dados dão uma visão mais granular do que se pode esperar fora do laboratório. (oeneo.ai)
Testes práticos do SpicyAPI mediram saídas em 1K, 2K e 4K, com alguns runs registrando 12 a 20 segundos em 1K e cerca de 22 segundos em 4K, em sessões de 11 de novembro. Diferenças são esperadas, já que pilha e fila de execução, além de modo Standard ou Highspeed, influenciam fortemente a latência percebida. (spicyapi.ai)
A síntese entre fontes sugere que o 4K sub-10 s anunciado é plausível em condições otimizadas e modo acelerado, enquanto medições públicas mostram um espectro que se aproxima do alvo nas configurações certas. O recado prático é medir no seu ambiente e alinhar expectativas com a escolha de modo e largura de banda de GPU.
Recursos centrais, aderência a prompt e referências múltiplas
Dois pontos se destacam. Primeiro, a aderência a prompt foi priorizada, com ajustes de pós-treinamento e um módulo de expansão de prompt que ajuda a transformar inputs curtos em instruções completas, inclusive com contexto de referência. Segundo, a capacidade de usar até 16 imagens de referência abre fluxos de edição assistida e consistência de estilo. Os materiais oficiais reforçam esses diferenciais. (minimax.io)
Casos práticos incluem criação de key art com consistência visual, transferência de estilo de um guia de marca e variantes coesas de um mesmo tema. Em pipelines de produto, 16 referências ajudam a capturar detalhes de identidade ou textura que seriam difíceis somente com texto. Documentação de terceiros também destaca a faixa efetiva de 4 a 20 MP e a flexibilidade de proporções entre 1:3 e 3:1, úteis para thumbnails, banners e telas panorâmicas. (github.com)
Em ambientes de revisão, a precisão semântica reduz o número de iterações e aprovações, algo que times de marketing e produto sentem no prazo. A combinação de prompts estendidos, referências ricas e 4K nativo aproxima o material gerado de uma peça pronta para uso, com menos retrabalho de upscaling e retouch.
Preços, modelos de uso e o custo de 4K
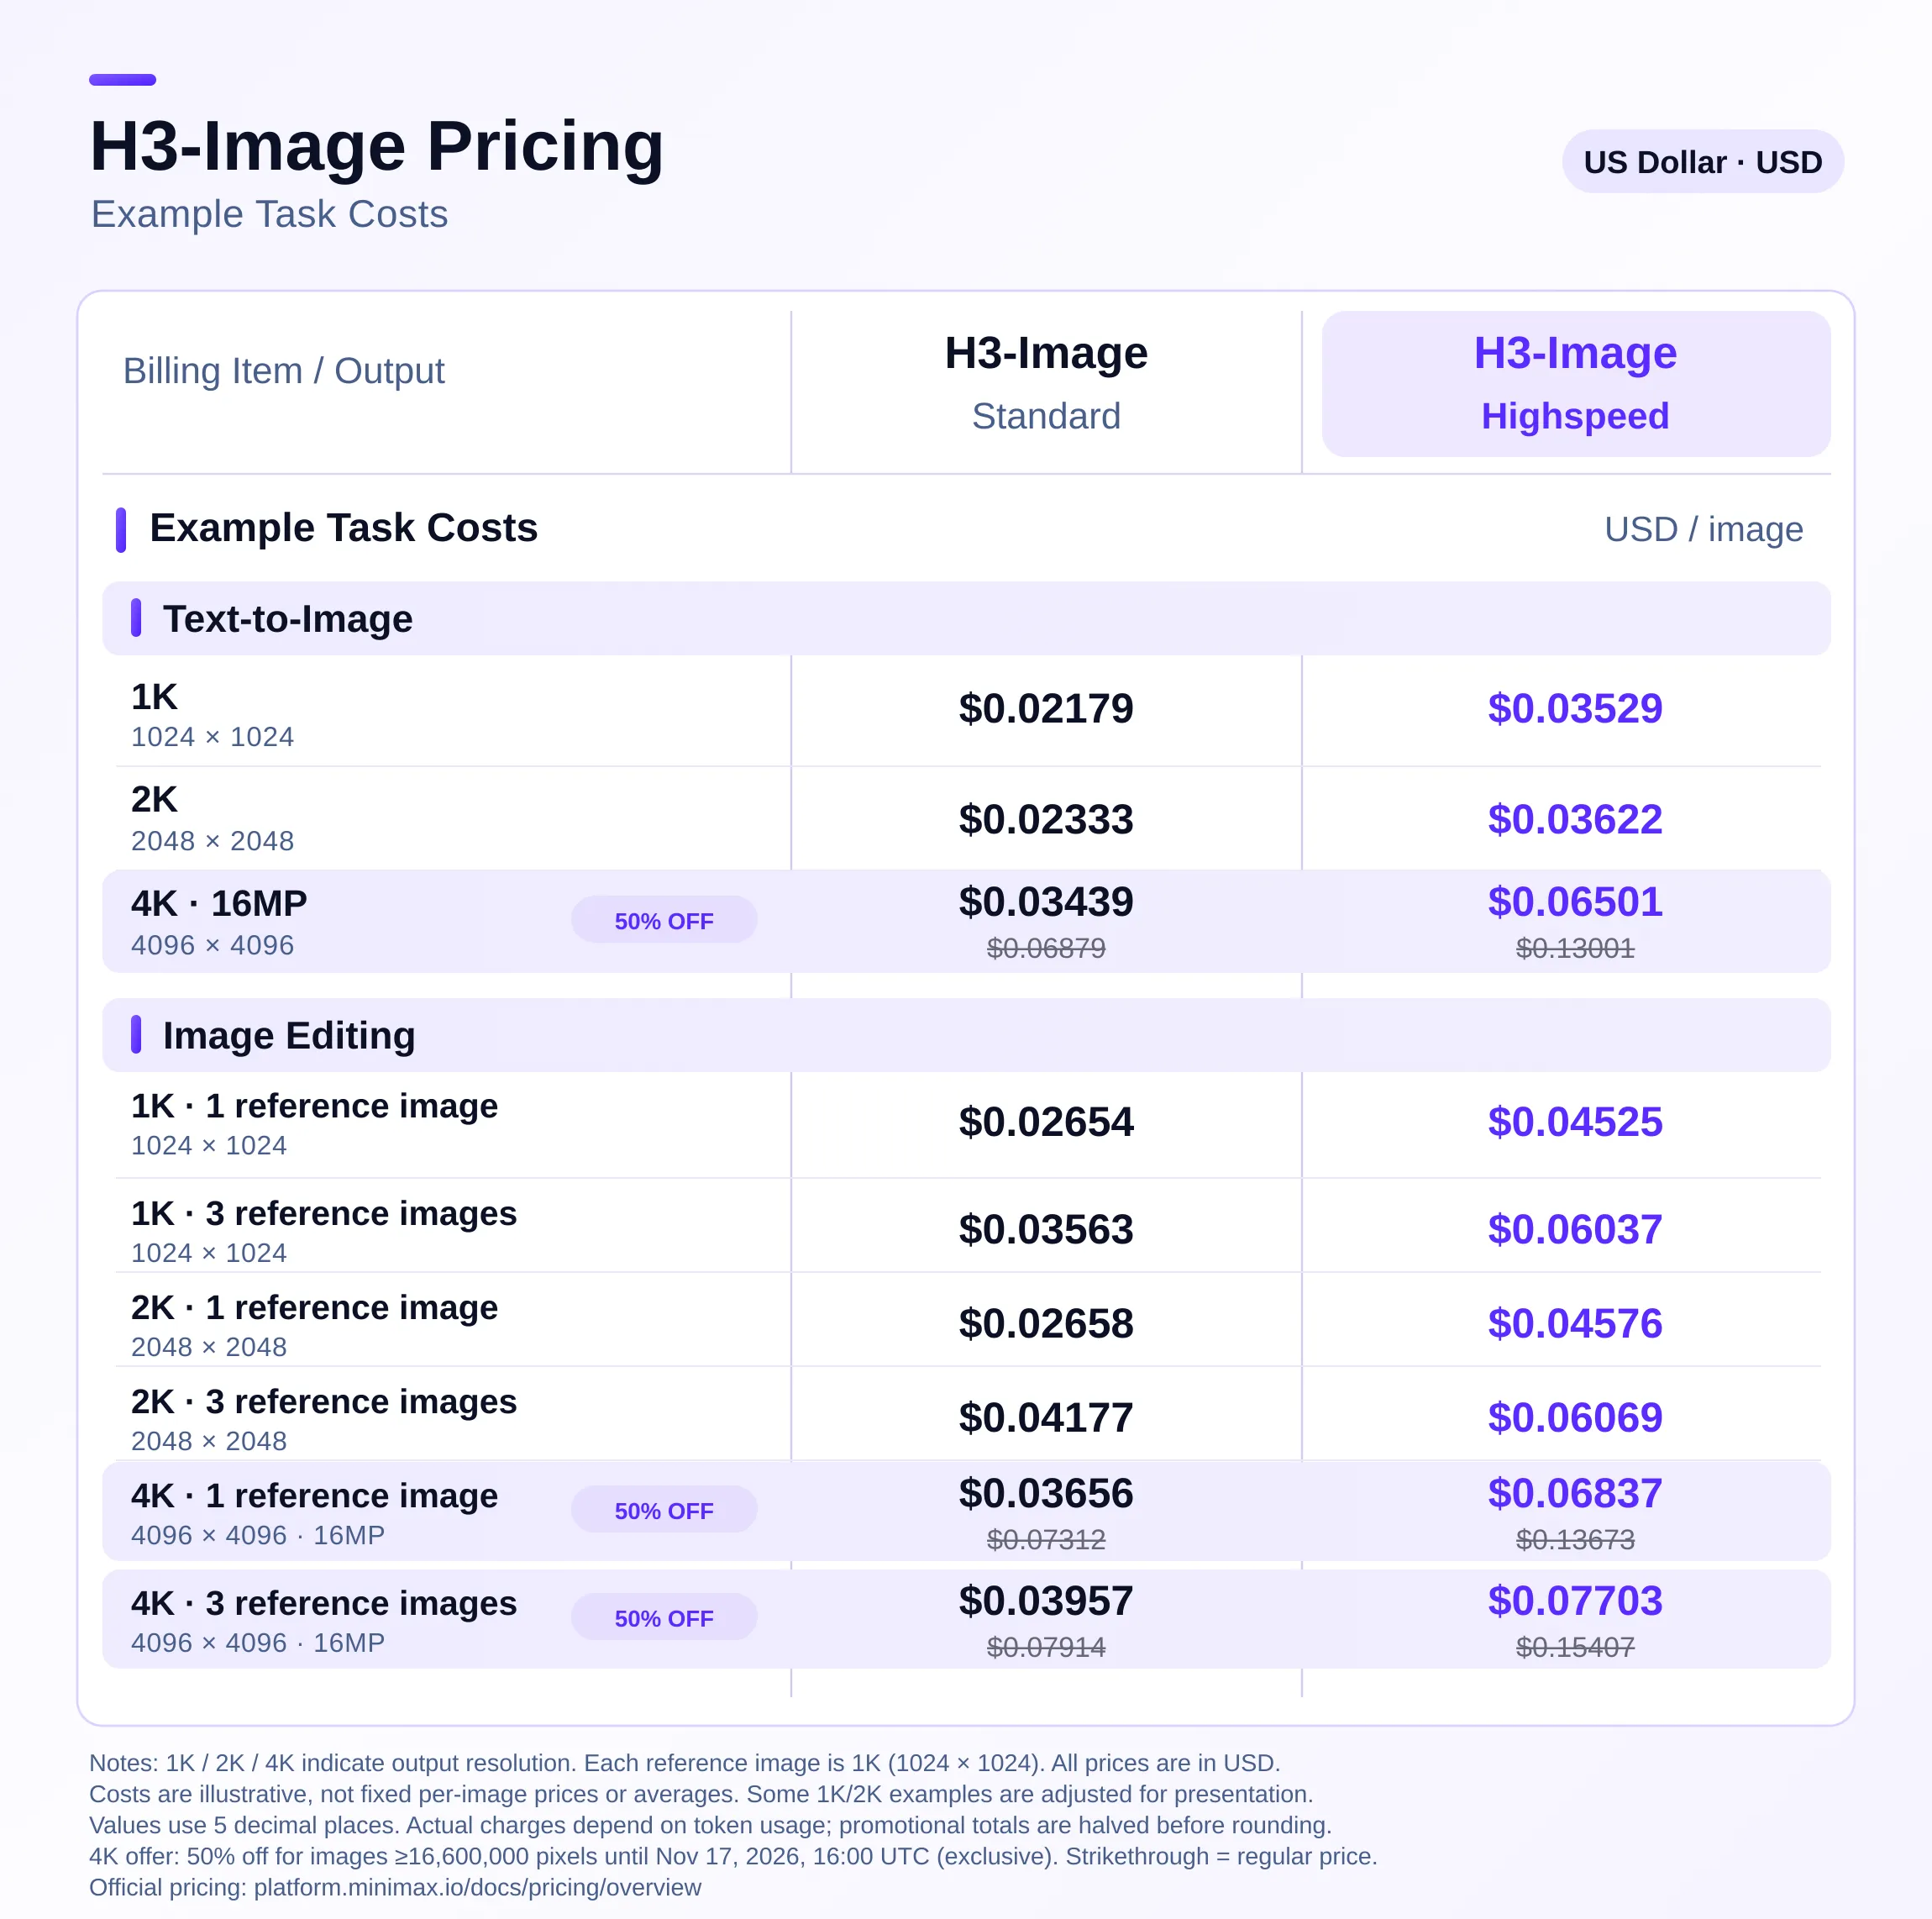
A página oficial lista exemplos de custos por tarefa e sinaliza desconto de 50 por cento na semana de lançamento para requisições 4K ou acima. Além disso, a MiniMax afirma preços entre 50 e 70 por cento dos equivalentes mainstream. Isso direciona o H3-Image para volume cotidiano, não apenas ocasiões especiais. (minimax.io)
Coberturas independentes citam valores de referência em dólar por imagem e reforçam o posicionamento de preço agressivo de estreia. Embora nem todas as fontes citem a GPU exata para o “4K em 10 s”, a triangulação preços, latência e caminho de API torna o modelo atraente para quem paga por throughput, como catálogos, marketplaces e editores de vídeo com key frames 4K. (thehype.news)
Do ponto de vista de ROI, 4K direto economiza tempo técnico, já que reduz dependência de upscalers, pipelines externos e reprocessamento. Equipes conseguem padronizar tamanhos finais e variações de aspecto sem criar degraus de qualidade entre SKUs. Isso tende a refletir em redução de custos por peça publicada.
Ferramentas, APIs e exemplos de integração
Para uso imediato, o H3-Image está disponível via MiniMax API Platform e nas ferramentas da casa, MiniMax Code e Hailuo AI. A documentação do design tool lista saídas em 1K, 2K e 4K, exportação em PNG, JPEG e WebP e até 10 imagens por execução. Para integração programática, os guias de API cobrem geração por texto e edição baseada em imagens. (design.minimax.io)
Em código, o repositório oficial organiza um fluxo completo, com parâmetros de requisição e tamanhos recomendados, além de scripts que replicam resultados da API em servidores locais. A especificação inclui limites como até 32 mil caracteres de prompt, truncamento acima de 4096 tokens e tamanhos exatos por aspecto para manter cerca de 16 MP. (github.com)
Para CLIs e agentes, há recursos práticos. O pacote CLI da MiniMax adiciona comandos de geração, inclusive para 2720x1536, e o ecossistema MCP traz ferramenta de edição com 1 a 16 referências por prompt. Isso reduz a barreira para montar demos e fluxos internos. (github.com)
Rodando localmente, requisitos e caminhos de deployment
Open weights significam liberdade, mas também responsabilidade com recursos. O README indica tamanhos de checkpoint, incluindo 68,65 GB para o DiT em BF16, cerca de 2,34 GB para o VAE e a necessidade do encoder de texto do H3. O guia descreve estratégias com SGLang e vLLM-Omni, de uma GPU B200 ou B300 até cenários com paralelismo Ulysses em 4 GPUs, além de caminhos para offload do encoder em H200. (github.com)
Para quem quer validar hardware antes de baixar tudo, existem páginas que sintetizam VRAM necessária e passos de clonagem. Embora a experiência real dependa de drivers, versão do PyTorch e afinamento de kernel, esses guias aceleram a prova de conceito. (doesitrun.ai)
No universo da comunidade, há tutoriais e workflows em ComfyUI e pipelines com otimizações como sparse attention. Apesar de variação de qualidade e necessidade de cautela, esses materiais ajudam a extrair 4K estável e a integrar edição com referências. Use como ponto de partida, validando sempre no seu caso de uso. (github.com)
Comparativos e contexto no mercado de modelos de imagem
H3-Image aterrissa em um ciclo em que modelos abertos de imagem e vídeo ganham massa crítica, com iniciativas como HunyuanImage 3.0 abrindo código e pesos. Esse pano de fundo fortalece interoperabilidade e acelera inovação aplicada, de editores a pipelines de mídia. (arxiv.org)
Relatos e papers sobre a família H3 indicam uma ambição multimodal mais ampla, com text encoder robusto e caminhos para vídeo, áudio e contextos combinados. Avaliações recentes de H3 em ambientes de consumo, como Apple Silicon, e estudos sobre raciocínio físico em variantes H3 reforçam a direção de modelos omni e a reutilização de componentes no H3-Image. (arxiv.org)
Na prática, o que se vê é uma disputa entre velocidade, custo por imagem e fidelidade a instruções. H3-Image mira o equilíbrio, com 4K rápido, forte aderência a prompt e referências profundas. O impacto imediato deve aparecer em times que já operam volume e precisam manter consistência visual entre peças.
Aplicações práticas e playbooks de adoção
- E-commerce e catálogos: combinar prompt curto com 6 a 10 referências do estilo da marca para gerar variações coerentes de fotografia hero em 4K. Reduz retrabalhos de upscaling e padroniza banners 16:9 e 1:1 para home e app. (github.com)
- Marketing de produto: usar 3 a 5 referências de diretrizes visuais e um prompt expandido, criando famílias de assets. Medir custo por peça versus a tabela de exemplo e a política de desconto em 4K. (minimax.io)
- Mídia e key frames: gerar quadros 4K como base para pipelines de vídeo, aproveitando a rapidez de 10 a 16 segundos por imagem reportada por fontes independentes. (oeneo.ai)
- Ferramentas internas: integrar MiniMax API nos sistemas internos de DAM, registrando metadados de referência e prompt expandido, permitindo rastreabilidade e reedição futura. (minimax.io)
Limitações, pontos de atenção e como testar certo
- Latência variável: o alvo de 4K em cerca de 10 s depende de modo, fila e GPU. Crie testes P50 e P95 no seu ambiente, variando Standard e Highspeed. Combine com monitoramento de custo por imagem. (minimax.io)
- Recursos locais: rodar on-prem exige VRAM e planejamento de checkpoints, além de escolha entre SGLang, vLLM-Omni e diffusers. Faça um smoke test com tamanhos de 4 a 8 MP antes de cravar 16 MP. (github.com)
- Precisão semântica: mesmo com aderência forte, prompts mal definidos ou referências inconsistentes geram variação. Use o expander e defina critérios de aprovação por caso de uso. (github.com)
- Claridade sobre preços: os exemplos e descontos ajudam, porém verifique a tarifa ativa e o modo escolhido, já que valores podem variar por região e volume. (minimax.io)
Conclusão
H3-Image avança a fronteira prática de modelos de imagem de código aberto com 4K rápido, aderência consistente a prompt e referências múltiplas. O material oficial registra metas ambiciosas, preço competitivo e integração ampla, enquanto medições públicas sugerem que os ganhos são alcançáveis com a pilha certa. Para quem trabalha com volume e padrão visual alto, MiniMax H3-Image pode encurtar ciclos e reduzir custos de produção com previsibilidade. (minimax.io)
O passo seguinte é pragmático. Meça latência e custo com seus prompts e imagens, compare Standard e Highspeed, avalie se 4K direto substitui upscaling no seu pipeline e, se fizer sentido, padronize tamanhos por aspecto próximos de 16 MP. Com pesos abertos e documentação clara, a adoção pode ser rápida, desde um teste por API até uma implantação local controlada. (github.com)
Leia também
Muse Spark Open, 816B open-weight da Meta roda no M5 Ultra
Muse Spark Open é o novo modelo open-weight da Meta com 816 bilhões de parâmetros, 42 bilhões ativos por token e janela de 1 milhão de tokens. Roda localmente em dois Mac Studios com M5 Ultra via MLX e já está disponível por APIs de provedores como OpenRouter, Baseten e Fireworks. Benefícios claros para agentes, desenvolvimento e privacidade.
9 min de leituraIA aplicadaOpenAI lança GPT-6.1 Sol Ultrafast a 8x na API e no Work
OpenAI apresentou o GPT-6.1 Sol Ultrafast, um novo modo que acelera drasticamente a geração de tokens, chegando a até 8x em cenários compatíveis. Disponível na API e no ChatGPT Work, a novidade mira workloads sensíveis a latência, com ajustes em preço e limites. Veja como funciona, quando usar, custos, casos práticos e comparativos com Fast e Standard.
9 min de leituraTecnologia e IAOpenAI reduz níveis da API de 5 para 3, topo cai a US$ 500
A OpenAI consolidou cinco níveis pagos de rate limit em três, com o topo agora acessível a partir de US$ 500 de gasto total. Isso reduz a barreira para escalar volume de requisições e tokens por minuto e pode acelerar lançamentos. Entenda o que muda, como qualificar e como ajustar pipelines, filas e backoff.
9 min de leituraIA e DesenvolvimentoCline lança app desktop para modelos open-weight no macOS e Windows
Cline Desktop é um app nativo para macOS e Windows focado em modelos open-weight. Com suporte a mais de 300 modelos, importação de tarefas de Claude Code e Codex, agendamentos e marketplace de plugins, a proposta é dar controle e flexibilidade a equipes de engenharia sem amarra em ecossistemas fechados.
8 min de leitura