NVIDIA Alpamayo 2 Edge traz raciocínio AV em tempo real ao DRIVE AGX Thor
Como a NVIDIA está levando modelos de raciocínio vision-language-action para dentro do veículo, com latência de 160 a 190 ms e implantação otimizada no DRIVE AGX Thor

Danilo Gato
Autor
Introdução
NVIDIA Alpamayo 2 Edge é a aposta para levar raciocínio de IA em tempo real para dentro do veículo, com inferência otimizada no DRIVE AGX Thor e latência pixel para trajetória entre 160 e 190 ms. O modelo combina percepção multimodal, explicações em cadeia de causalidade e planejamento, mantendo o ciclo fechado exigido por condução autônoma. (developer.nvidia.com)
A importância vai além do desempenho bruto. Ao tornar o raciocínio adaptativo e eficiente, Alpamayo 2 Edge abre caminho para decisões mais explicáveis e confiáveis sob limites estritos de computação embarcada, algo validado por um fluxo completo que inclui quantização, exportação ONNX e aceleração com TensorRT Edge-LLM no Thor. (developer.nvidia.com)
Este artigo detalha como o modelo funciona, por que o raciocínio onboard importa, o que muda na engenharia de latência, como implantar no DRIVE AGX Thor, como medir a qualidade das explicações com AlpaJudge e como conectar tudo isso a um ciclo de melhoria contínua.
O que o Alpamayo 2 Edge entrega na prática
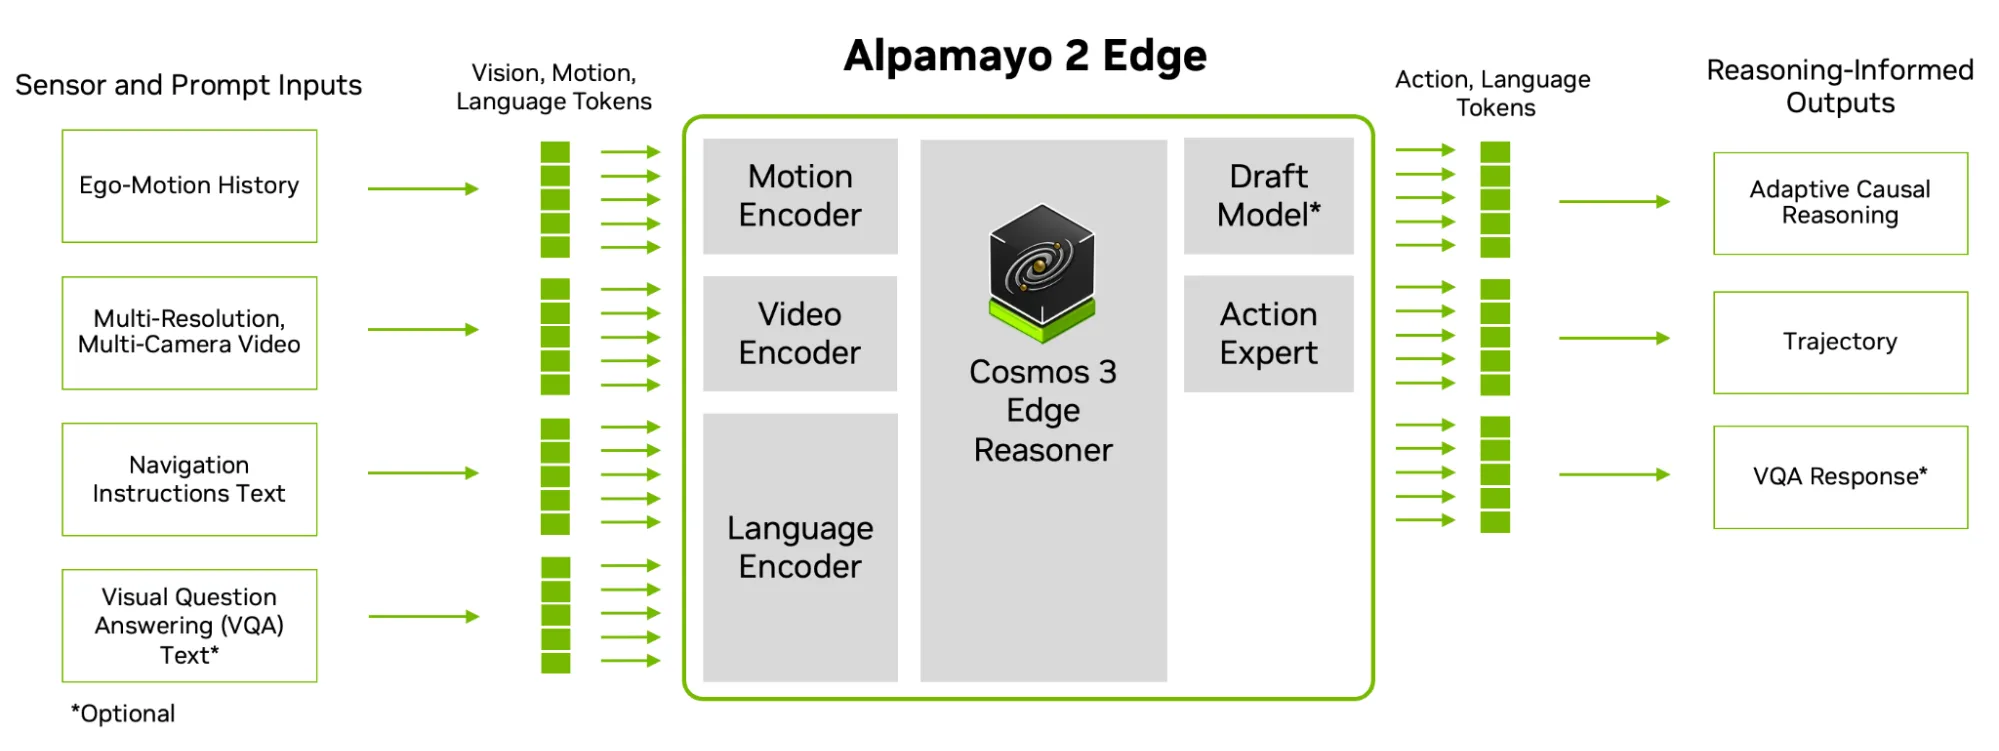
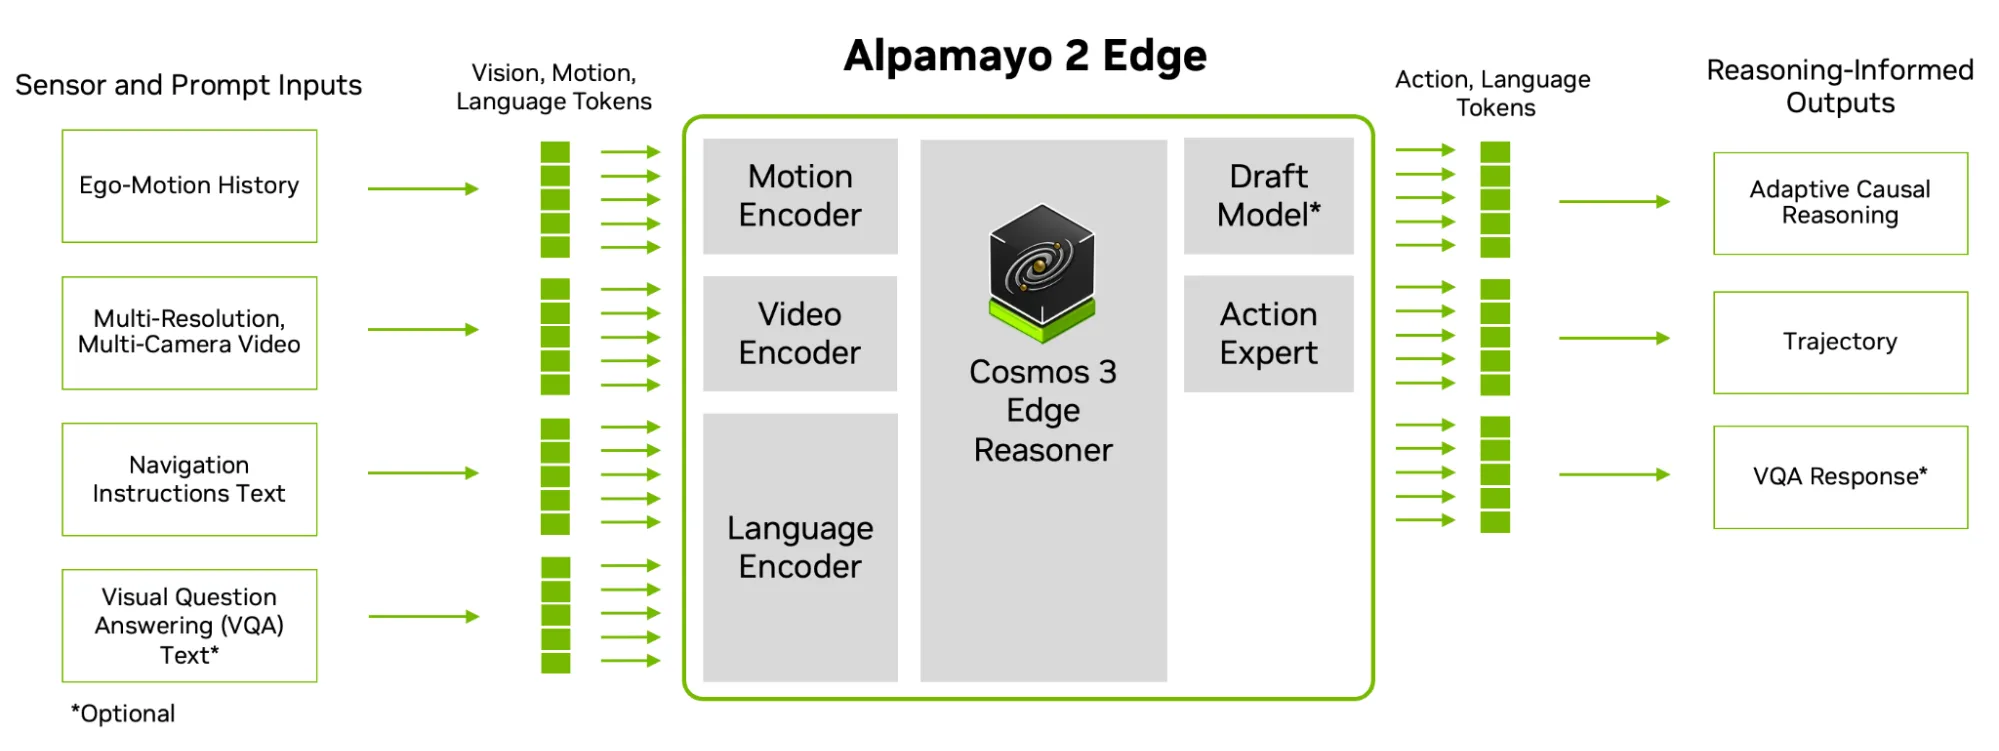
Alpamayo 2 Edge é um VLA de cerca de 2 bilhões de parâmetros, apoiado em um backbone Nemotron do Cosmos 3 Edge, com um especialista de ação por difusão para gerar trajetórias a partir de vídeo multicanais, histórico de egomotion e instruções de navegação. O raciocínio é adaptativo, só é produzido quando necessário, o que reduz geração de tokens e custo computacional durante condução rotineira. (developer.nvidia.com)
Nos benchmarks compartilhados, o modelo supera o Qwen-Drive-1.0 em tarefas centrais, do loop fechado de direção ao entendimento de cena, apresentando ganho expressivo na distância até incidentes com culpa no simulador AlpaSim. Parceiros iniciais relatam frequência de 10 Hz no AGX Thor após otimizações e ganhos de estabilidade de faixa e recuperação de desvios em comparação a versões anteriores. (developer.nvidia.com)
Resultados abertos do “irmão professor” Alpamayo 2 Super ajudam a contextualizar a família: minADE_6 de 0,911 m em 6,4 s em conjunto desafiador, score de raciocínio 0,433 e superioridade em LingoQA frente a VLMs maiores, mostrando potencial de distilação para modelos compactos que rodam dentro do carro. Essa estratégia, professor para aluno, é o que fundamenta o Edge. (developer.nvidia.com)
Por dentro da arquitetura e do raciocínio adaptativo
O pipeline começa com vídeo surround multi-resolução, histórico de movimento e texto de navegação. Encoders dedicados de vídeo, movimento e linguagem alimentam o Cosmos 3 Edge Reasoner. Um rascunhador de geração e um especialista de ação por difusão produzem a explicação causal e as trajetórias. Em situações nominais, o modelo emite um token especial, omitindo explicações longas, o que reduz latência e custo. (developer.nvidia.com)
Esse design nasce de uma linha de pesquisa que liga raciocínio a ação com CoC, vista no Alpamayo-R1, onde a integração de explicações causais com predição de trajetória melhora a tomada de decisão em cenários long tail. A abordagem usa dados com CoC e pós-treinamento com RL para reforçar consistência entre raciocínio e ação, princípio seguido e refinado no Edge. (d1qx31qr3h6wln.cloudfront.net)
Uma implicação prática é clara. Quando a cena é trivial, manter o planejamento rápido e cortar a verbosidade de raciocínio evita gargalos. Quando a cena é ambígua, a explicação aparece, documentando causa e efeito. Isso habilita auditoria e depuração, além de treinar políticas mais compactas que herdam o “como” e o “por quê” do professor maior.
Latência, taxa de atualização e por que 160 a 190 ms importam
Condução autônoma exige fechamento de loop estável, tipicamente abaixo de 200 ms em pipelines que incluem percepção, raciocínio e controle, já que oscilações de latência degradam qualidade e segurança. Alpamayo 2 Edge, otimizado com TensorRT e TensorRT Edge-LLM, atinge 160 a 190 ms do pixel à trajetória no DRIVE AGX Thor-X medido com DriveOS 7.2.7.0, CUDA 13.4 e TensorRT 11.3.1.9, o que favorece controlabilidade no veículo. (developer.nvidia.com)
Taxas de 10 Hz relatadas por parceiros durante planejamento online reforçam esse ponto, mostrando que, com otimizações certas, um VLA pode sustentar raciocínio explicável dentro do envelope do Thor. Em contextos de comparação de hardware, estudos recentes de VLAs em edge reforçam que memória de alta largura de banda, fusão de kernels e pesos de baixa precisão são cruciais para latência baixa, alinhando-se ao caminho que a NVIDIA toma com Edge-LLM. (developer.nvidia.com)
Em mercados onde a operação urbana é dinâmica, 10 Hz com latência estável permite reagir a pedestres e agentes de trânsito mantendo previsibilidade do controle. Uma janela de 160 a 190 ms preserva a capacidade de atualizar trajetória sem atrasos acumulativos que poderiam induzir overshoot ou frenagens bruscas, algo observável em literaturas de controle embarcado e em medições independentes de plataformas Thor. (microsoft.com)
Como implantar no DRIVE AGX Thor, do checkpoint ao motor TensorRT
O fluxo recomendado pela NVIDIA é direto e reproduzível. O Developer Hub do Alpamayo traz a receita para Thor: preparar o checkpoint do Alpamayo 2 Edge e o rascunhador DFlash2, calibrar escalas FP8, exportar gráficos ONNX, construir engines no TensorRT com plugins do TensorRT Edge-LLM e rodar o harness Python, comparando a saída otimizada com uma referência PyTorch BF16. (developer.nvidia.com)
O suporte oficial do TensorRT Edge-LLM para DRIVE Thor com DriveOS 7.2 está documentado na matriz de suporte, detalhando dependências e versões de TensorRT com foco em compatibilidade de SM e contêineres de SDK. Para cenários mistos, a própria documentação do Edge-LLM e repositórios de exemplos mostram como ativar rascunho especulativo, fusão de kernels e quantização de forma segura. (github.com)
A página do DRIVE AGX Developer esclarece o ecossistema de kits, ferramentas e APIs como CUDA, cuDNN e TensorRT que compõem a base do stack. Em campo, equipes relatam implantação com versões próximas, como DriveOS 7.2.5, reforçando a maturidade do caminho de produção. (developer.nvidia.com)
Medindo qualidade de raciocínio com AlpaJudge
Avaliar só a trajetória não basta quando a promessa é dirigir e explicar. O AlpaJudge é o avaliador calibrado por humanos usado no desenvolvimento do Alpamayo 2 Edge. Ele existe em duas variantes, uma baseada em referência textual e outra que analisa frames sincronizados e contexto de ação, retornando probabilidades por rubrica e notas por componente e geral. Fluxos de trabalho públicos mostram como rodá-lo em amostras do PhysicalAI-AV e como conectar as notas a seleção de dados e a recompensas de RL. (developer.nvidia.com)
O resultado é um circuito fechado de melhoria. A equipe pode classificar raciocínios fracos, procurar contradições entre explicação e ação, priorizar cenas com valor de aprendizagem alto e alimentar um ciclo de pós-treinamento que melhora direção e coerência. O card do modelo no Hugging Face e a página de informações da NVIDIA apontam para benchmarks adicionais relevantes, como LingoQA e WaymoQA, úteis para rastrear ganhos de linguagem e raciocínio. (huggingface.co)
Conectando com o “professor” Alpamayo 2 Super e o ecossistema de simulação
O Edge herda competências do Alpamayo 2 Super, um modelo aberto de grande porte posicionado como professor para distilação em alunos compactos que rodam no Thor. Materiais oficiais destacam ganhos de escala e adoção na comunidade, com desempenho superior em tarefas de raciocínio e dados públicos. A própria NVIDIA já posicionou o Super como base para gerar auto-rótulos de CoC e trajetórias, alimentando o treinamento do Edge. (blogs.nvidia.com)
No ecossistema de simulação, o AlpaSim e o NuRec aparecem como peças para fechar o ciclo de dados físico-digitais, com APIs gRPC para orquestração distribuída e suporte a políticas Alpamayo e Transfuser, entre outras. Esse ambiente permite teste fechado de loop, avaliação de colisões e saídas de pista e análise de explicações, ponto crítico para transferir melhorias do laboratório para a rua. (developer.nvidia.com)
Casos reais e validação de engenharia
Os trechos do blog técnico citam três parceiros com relatos complementares. PORT reporta ganhos rápidos em simulações NuRec com dados de Londres, duplicando a taxa de manutenção de faixa em relação ao Alpamayo 1.5 e planejando duas vezes mais rápido que uma política manual no mesmo GPU. Niulinx descreve redução de minADE e RMSE, além de migração veloz de simulação para testes em veículo real. Embedl reporta 10 Hz de planejamento em menos de 48 horas no AGX Thor, após otimização, um forte indicador de maturidade da pilha. (developer.nvidia.com)
Em paralelo, o stack de implantação não vive no vácuo. A documentação do Edge-LLM e trabalhos recentes de benchmark de VLA em hardware de borda mostram onde o tempo é gasto no pipeline, quais otimizações rendem mais e por que decodificação especulativa e pesos de baixa precisão são caminhos promissores. Isso dá ao time de engenharia um mapa para perseguir latência estável sem sacrificar qualidade. (arxiv.org)
Guia prático de adoção, do POC ao piloto
- Começo enxuto. Rodar o checkpoint BF16 em GPU validada e familiarizar-se com entradas, prompts e geração de trajetórias. Mapeie latência e variabilidade com seu conjunto de cenas. (huggingface.co)
- Otimize para o Thor. Siga a receita oficial, gere engines no TensorRT, habilite Edge-LLM e DFlash2, e valide byte a byte contra a referência BF16 para garantir equivalência funcional. Registre a latência em cada estágio. (developer.nvidia.com)
- Avalie raciocínio. Incorpore AlpaJudge-RB ou RF conforme as evidências disponíveis. Não confunda boa direção com boa explicação, reporte ambas. (developer.nvidia.com)
- Feche o ciclo. Selecione exemplos que maximizam aprendizagem, use notas do AlpaJudge como sinal de recompensa e itere com RL pós-treino, mantendo trilhas de versionamento de engines e datasets. (developer.nvidia.com)
- Prepare o stack do veículo. Alinhe versões de DriveOS suportadas e a matriz do Edge-LLM, garantindo consistência de SM e de TensorRT, já que misturar componentes quebra compatibilidade e mede mal latência. (github.com)
O que observar nos próximos meses
- Kernel fusion e quantização. Esperar extensão de fusões e 4 bits a mais modelos e plataformas, já que ganhos de 2,6 a 2,9 vezes foram medidos em cenários específicos. Isso é combustível direto para mais hertz com o mesmo envelope térmico. (arxiv.org)
- Integração com agentes físicos. O avanço de toolkits de agentes e benchmarks MLPerf Edge em Thor sinaliza que workloads agentic já são prioridade, sugerindo que pipelines de raciocínio e ação ficarão mais padronizados. (2.zoppoz.workers.dev)
- Evolução da família Alpamayo. O “professor” Super já está disponível para uso comercial e serve de fonte de dados e estilos de raciocínio, portanto esperar novas rotas de distilação e autocorreção para a linha Edge. (blogs.nvidia.com)
Conclusão
Raciocínio em tempo real dentro do veículo deixou de ser promessa distante. Com Alpamayo 2 Edge, a NVIDIA demonstra que é possível cruzar percepção, explicação causal e planejamento com latência de 160 a 190 ms no DRIVE AGX Thor, sustentando 10 Hz em cenários práticos e com um caminho de implantação reproduzível. O fator diferencial não é só a velocidade, e sim a capacidade de explicar, medir e melhorar, amarrando dados reais, simulação e RL pós-treinamento. (developer.nvidia.com)
Para times que precisam acelerar de POC a piloto, o recado é claro. Começar com o checkpoint aberto, seguir a receita oficial para Thor, medir raciocínio com AlpaJudge e fechar o ciclo com RL cria um motor de melhoria contínua. Em um espaço onde milissegundos e confiabilidade importam, essa disciplina é o que transforma um bom demo em direção autônoma escalável. (huggingface.co)
Leia também
NVIDIA, Jensen Huang admite infidelidade, conselho investiga
Jensen Huang, CEO da NVIDIA, admitiu infidelidade em mensagem interna e o conselho abriu uma investigação independente ligada a preocupações de segurança nacional. Veja o que foi oficialmente dito, o que a imprensa apurou, os possíveis impactos em governança, regulação e no mercado de IA, além de sinais para investidores e empresas de tecnologia.
7 min de leituraTecnologiaEUA veem romance de Jensen Huang, da Nvidia, com espiã MSS
Relatórios da imprensa e um suposto memorando de inteligência indicam que Jensen Huang, CEO da Nvidia, manteve um romance com Alice Huang, apontada como agente da MSS. A Nvidia abriu investigação interna e o caso eleva a pressão geopolítica sobre a cadeia de IA e exportações para a China. Entenda o que foi confirmado, o que segue como alegação, e como isso pode afetar políticas, mercado e governança.
8 min de leituraTecnologiaAlexa para Compras da Amazon permite pedir mantimentos por texto
Alexa para Compras agora aceita pedidos por mensagem de texto, começando com convites para clientes nos EUA e expansão nas próximas semanas. A IA busca, compara, recomenda e pode concluir compras, incluindo mantimentos e reabastecimentos, além de rastrear preços por até um ano. Veja como funciona, cases reais, oportunidades e pontos de atenção.
10 min de leituraTecnologiaAutofill aprimorado do Chrome agora puxa dados do Gmail
O Chrome conectou o Gmail ao Autofill para sugerir dados como códigos de rastreio e reservas de voos direto nos formulários. Com Gemini e Personal Intelligence, a novidade agiliza tarefas repetitivas, preserva o controle do usuário nas configurações e começa a chegar aos EUA em desktop, Android e iOS.
9 min de leitura