Nvidia lança o DreamDojo, modelo de mundo para robôs com 44 mil horas
O Nvidia DreamDojo redefine como robôs aprendem ao treinar em mais de 44 mil horas de vídeos humanos, conectando visão, ação e física em um modelo aberto que acelera a era da Physical AI.

Danilo Gato
Autor
Introdução
Nvidia DreamDojo é a palavra‑chave aqui, e a notícia é clara, a Nvidia lançou um modelo de mundo para robôs treinado em mais de 44 mil horas de vídeos humanos, com código e artefatos abertos, posicionando a Physical AI como próximo salto da computação aplicada. O anúncio detalhado pela VentureBeat em 9 de fevereiro de 2026 coloca o DreamDojo como peça central no roteiro de robótica da companhia.
Os pesquisadores por trás do projeto publicaram um artigo técnico que descreve o DreamDojo como um modelo fundacional capaz de aprender dinâmicas do mundo e controle hábil a partir de vídeos egocêntricos, citando 44 mil horas, em versões atualizadas aparece 44.711 horas, o que o tornaria o maior dataset desse tipo já usado para pré‑treino de modelos de mundo.
O que é o DreamDojo e por que importa
O DreamDojo é um modelo de mundo pixel‑a‑pixel, projetado para prever como o ambiente evolui quando um agente executa ações. Em vez de depender de simulações físicas tradicionais, ele aprende uma representação compacta do mundo observando pessoas executarem milhares de tarefas do dia a dia, depois adapta esse conhecimento para robôs específicos. Esse desenho promete reduzir tempo e custo de coleta de dados robóticos diretamente no hardware, viabilizando pré‑treino massivo e pós‑treino leve.
A VentureBeat resume o posicionamento, o DreamDojo é um “world model” que unifica visão, física e ação, um passo alinhado à estratégia maior da Nvidia para a Physical AI, que inclui famílias de modelos abertos, novos pipelines de dados e parcerias com fabricantes de robôs e laboratórios. O movimento ancorado em GTC 2026 mira levar agentes inteligentes do digital para o físico.
O dataset por trás do avanço
Segundo o paper e reportagens especializadas, o DreamDojo usa um conjunto de vídeos egocêntricos humanos de escala inédita, citado como 44 mil ou 44.711 horas, abrindo margem para cobertura de mais de 6 mil tipos de tarefas e mais de um milhão de trajetórias, número raramente visto em robótica. Essa abundância contrasta com conjuntos clássicos de robôs, que costumam ficar na casa de centenas de horas, e ajuda a explicar por que um modelo de mundo pode generalizar melhor.
Algumas análises independentes destacam que treinar com vídeos de primeira pessoa acelera a internalização de affordances, como manipular ferramentas, montar objetos ou lidar com roupas, antes de qualquer contato com o robô real. Isso reduz desgaste de hardware, minimiza riscos e permite que o pós‑treino foque idiossincrasias de motores, engrenagens e limites de torque de cada plataforma.
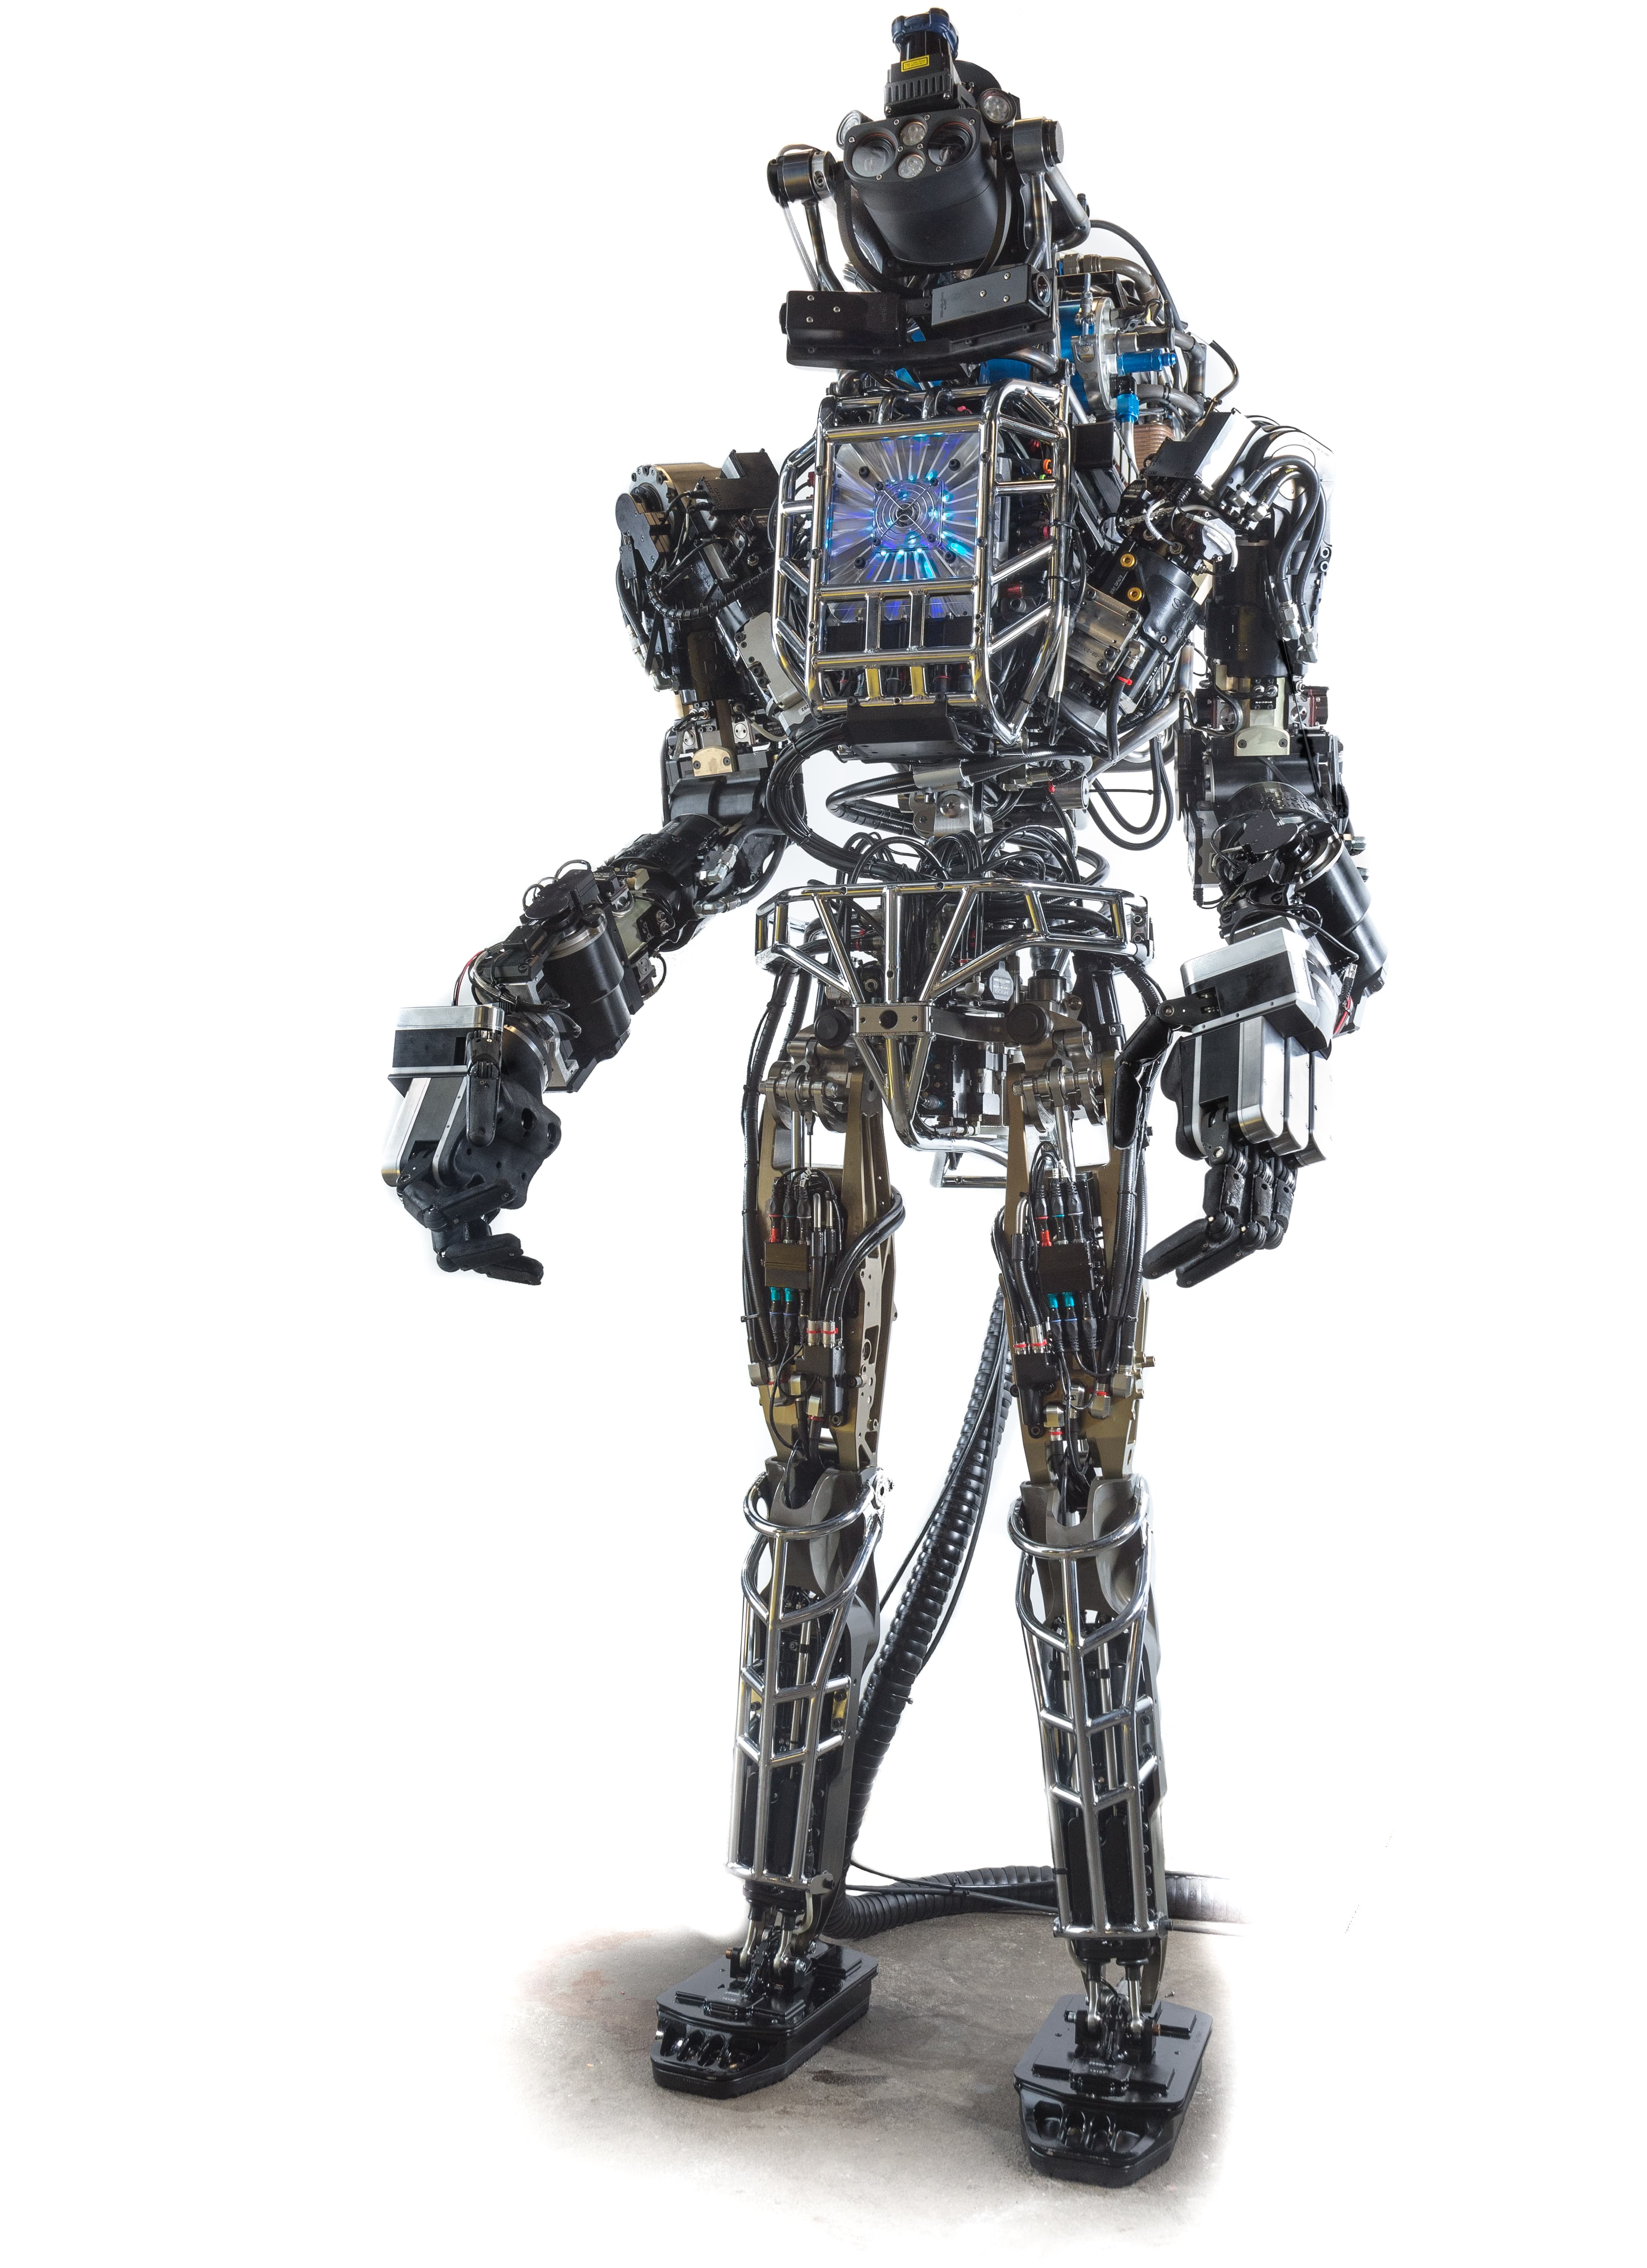
![Humanoide de pesquisa, útil para ilustrar agentes gerais]
Como o modelo aprende, do pré‑treino ao pós‑treino
O pipeline relatado pelas fontes segue dois estágios. No pré‑treino, o DreamDojo aprende a prever quadros futuros e estados latentes a partir de vídeos humanos, construindo um simulador implícito de física e interação. No pós‑treino, pequenas quantidades de dados do robô alvo, coletados de forma supervisionada ou com teleoperação limitada, calibram o mapeamento entre comandos e dinâmicas específicas daquele hardware. Essa combinação tira proveito do que há de mais farto, vídeo humano, e usa o que é escasso, dados de robô, apenas para ajuste fino.
O artigo técnico enfatiza a capacidade do modelo em raciocinar sobre manipulação hábil, algo historicamente difícil por causa da diversidade de contatos, atritos e deformações. Ao prever diretamente em pixels, o DreamDojo evita dependência de simuladores rígidos, o que costuma gerar lacunas sim‑para‑real. É um avanço incremental sobre linhas de pesquisa em world models e vídeo‑modeling, agora guiadas para execução física.
Onde o DreamDojo se encaixa no ecossistema Nvidia
A Nvidia tem empilhado três pilares para acelerar a Physical AI, modelos abertos, pilhas de software Isaac e uma fábrica de dados aberta. Durante a GTC 2026, press releases oficiais destacaram a expansão de famílias de modelos, como Cosmos para geração de mundos e raciocínio, e a linha GR00T para humanoides. O DreamDojo se posiciona como o bloco de modelagem de mundo que alimenta agentes e políticas de controle.
Relatos da imprensa técnica mencionam que a família GR00T, voltada para visão, linguagem e ação, vem ganhando maturidade, com versões N1.6 e N1.7 e uma prévia do GR00T N2, planejado para 2026, com ganhos expressivos em tarefas inéditas e ambientes novos. Junto disso, a coalizão de modelos abertos e o ecossistema de parceiros em robótica industrial e humanoides indicam esforços coordenados para produção.
![Braços robóticos industriais, sinal do destino prático da Physical AI]
Benefícios práticos para times de robótica
- Coleta de dados mais barata, em vez de meses de teleoperação cara, times podem alavancar grandes acervos de vídeos humanos curados e de domínio público, depois gravar poucas horas por robô para fechar a lacuna de controle.
- Ciclos de iteração mais rápidos, políticas podem ser validadas no modelo de mundo antes de tocar no chão de fábrica, reduzindo paradas e retrabalho. A cobertura de tarefas comuns, como parafusamento, encaixe e embalagem, tende a se beneficiar da diversidade de vídeos.
- Melhor transferência sim‑para‑real, ao aprender física implícita a partir do mundo real, o DreamDojo evita calibragens exaustivas de simulador, ponto crítico nas últimas gerações de robôs generalistas.
Limitações e perguntas em aberto
- Cobertura de long tail, mesmo com 44 mil mais horas, a cauda longa de tarefas industriais, tolerâncias de micrômetros e materiais específicos pode exigir dados complementares. O próprio material da Nvidia sugere que modelos abertos e fábricas de dados precisam evoluir juntos.
- Métricas padronizadas, falta consenso sobre benchmarks que medem quão bem um modelo de mundo melhora sucesso de tarefas generalistas. Há referências em eventos como GTC sobre arenas de avaliação, porém a indústria ainda busca métricas comuns.
- Integração com segurança funcional, normas e certificações, sobretudo em células de manufatura e saúde, continuam a ser determinantes na velocidade de adoção, mesmo com ganhos de aprendizado. Relatórios de mercado reforçam a importância de plataforma completa, não só do modelo.
Exemplos de aplicação imediata
- Logística e embalagem, onde robôs precisam manipular objetos variados, o DreamDojo pode acelerar a criação de políticas robustas a variações de iluminação, oclusão e deformações. A pré‑exposição a vídeos de atividades humanas de embalagem e empacotamento ajuda o modelo a absorver padrões úteis.
- Montagem leve, em eletrônicos e bens de consumo, dados humanos de uso de ferramentas manuais e encaixes finos oferecem sinal rico para habilidades de precisão. O pós‑treino no robô alinha limitações de atuadores.
- Serviços e humanoides, a linha GR00T, citada nos anúncios de GTC, indica que a Nvidia quer conectar percepção, linguagem e ação com modelos de mundo, uma trilha natural para robôs de atendimento e assistência.
O que dizem as coberturas e a comunidade
Além da reportagem da VentureBeat, diversos sites e fóruns técnicos repercutiram que o DreamDojo foi aberto e que sua principal contribuição é viabilizar simulações implícitas de física diretamente em pixels, usando 44.711 horas de vídeo humano real. Essa leitura converge com a ideia de reduzir dependência de simuladores e levar políticas a tempo real.
Alguns resumos informativos reforçam a tese de que a melhor forma de escalar humanoides não é apenas coletar dados robóticos, mas ensinar os robôs a observar humanos primeiro, depois especializar. Isso está presente em análises de design e tendências publicadas após o anúncio inicial.
Como começar, trilha prática para equipes
- Estudar o paper e artefatos, entender a estrutura do dataset humano e as interfaces de pós‑treino para hardware alvo. O artigo no arXiv é ponto de partida confiável para detalhes técnicos.
- Mapear casos de uso onde vídeo humano está disponível em abundância, como montagem leve, inspeção visual e logística. Relatórios e comunicados do GTC 2026 mostram um ecossistema pronto para adoção em escala, com parceiros industriais e humanoides.
- Planejar a validação, usar o modelo de mundo para testar políticas antes da célula produtiva. Isso segue a abordagem destacada em coberturas independentes sobre o DreamDojo e sua proposta de reduzir o ciclo de integração.
Reflexões e insights
Modelos de mundo sempre foram o elo que faltava entre percepção rica e ação confiável. Quando a fonte é vídeo humano de grande escala, a representação tende a carregar regularidades do cotidiano que simuladores não capturam com fidelidade. O DreamDojo sinaliza que a próxima geração de robôs vai se beneficiar de “aprender por observação” em larga escala, depois ajustar pouca coisa no chão de fábrica.
O ecossistema anunciando Cosmos, GR00T, fábricas de dados e parcerias sugere que a Nvidia ambiciona um stack completo para levar agentes físicos ao mercado. Se a estratégia funcionar, veremos ciclos de desenvolvimento mais curtos, custos menores e, principalmente, generalização melhor fora do laboratório. A jornada depende de padronização de métricas e de segurança funcional, mas a direção está traçada.
Conclusão
O Nvidia DreamDojo, treinado com mais de 44 mil horas de vídeos humanos e apresentado ao público no início de 2026, coloca a modelagem de mundo no centro da Physical AI. Com pré‑treino massivo e pós‑treino específico, times podem acelerar do protótipo ao piloto com menor atrito, aumentando a chance de transferir habilidades para o real.
O próximo ano deve mostrar se a promessa fecha na prática. A Nvidia prepara terreno com famílias de modelos abertas, parceiros industriais e humanoides, além de pipelines de dados. Se benchmarks e segurança acompanharem, o DreamDojo pode tornar comum o que hoje ainda parece laboratório, robôs que primeiro aprendem com humanos em vídeo, depois trabalham com confiança no mundo físico.
Leia também
Claude Anthropic acelera descoberta de fármacos com 6 parceiros, lança programas
A Anthropic publicou resultados iniciais do uso do Claude para acelerar a descoberta de fármacos com seis parceiros, além de lançar programas próprios focados em doenças raras. O post analisa o que muda na prática, dos alvos às etapas pré clínicas, com exemplos reais, ganhos de velocidade e limites do que ainda é hipótese.
8 min de leituraInteligência ArtificialGoogle lança Gemini 4 Carbon, segurança e IA de longo prazo
O Google apresentou o Gemini 4 Carbon com promessa de cibersegurança de ponta, melhor desempenho em tarefas de longo horizonte e rollout responsável. O modelo inicia com acesso para equipes de defesa, preços promocionais por token e ganhos em benchmarks de exploração, detecção de vulnerabilidades e patching. Entenda o que muda na prática e como se preparar.
9 min de leituraInteligência ArtificialCopilot Harness da Microsoft no Foundry para IA multimodelo
A Microsoft anunciou o Copilot Harness no Foundry, oferecendo uma camada de orquestração multimodelo para agentes, suporte a MCP, runtime em Rust e integração com GitHub Copilot. Entenda o que muda na arquitetura, os ganhos de desempenho, como funciona o roteamento de modelos e como começar de forma segura e escalável.
12 min de leituraInteligência ArtificialSatélite do Project Suncatcher do Google envia a primeira resposta de IA da órbita via TPU
O Project Suncatcher do Google registrou a primeira resposta de IA da órbita, processada por um TPU de classe data center a bordo de um satélite. O feito, após o lançamento no Transporter 18 com a SpaceX e parceria com a Planet, valida a próxima fase de testes térmicos e de radiação, e abre caminho para avaliar computação de IA escalável no espaço.
11 min de leitura