Processo Dreaming do Claude organiza memória e corrige erros
O novo estudo da Anthropic detalha componentes da memória de agentes e mostra como o processo Dreaming permite organizar notas, construir wikis e corrigir falhas com ganhos práticos em benchmarks.

Danilo Gato
Autor
Introdução
A memória de agentes deixou de ser conceito abstrato e virou engenharia aplicada. No dia 6 de novembro de 2026, a Anthropic publicou uma análise técnica sobre os componentes da memória de agentes em Claude e apresentou o processo Dreaming, um ciclo offline que organiza notas, constrói representações e corrige erros registrados durante sessões anteriores. O estudo discute como registrar, consolidar e injetar lembranças melhora agentes em tarefas de longo horizonte, com dados de benchmarks e cases práticos. (anthropic.com)
Para quem projeta sistemas com componentes da memória de agentes, a proposta é clara, usar logs e notas como matéria prima, depois aplicar Dreaming para revisar transcrições, promover insights e manter um conjunto enxuto de lembranças que realmente importam. O resultado aparece em tarefas reais, de consultas em bancos de dados a jogos longos como Pokémon, além de avaliações jurídicas complexas. (anthropic.com)
O que a Anthropic chama de memória de agente
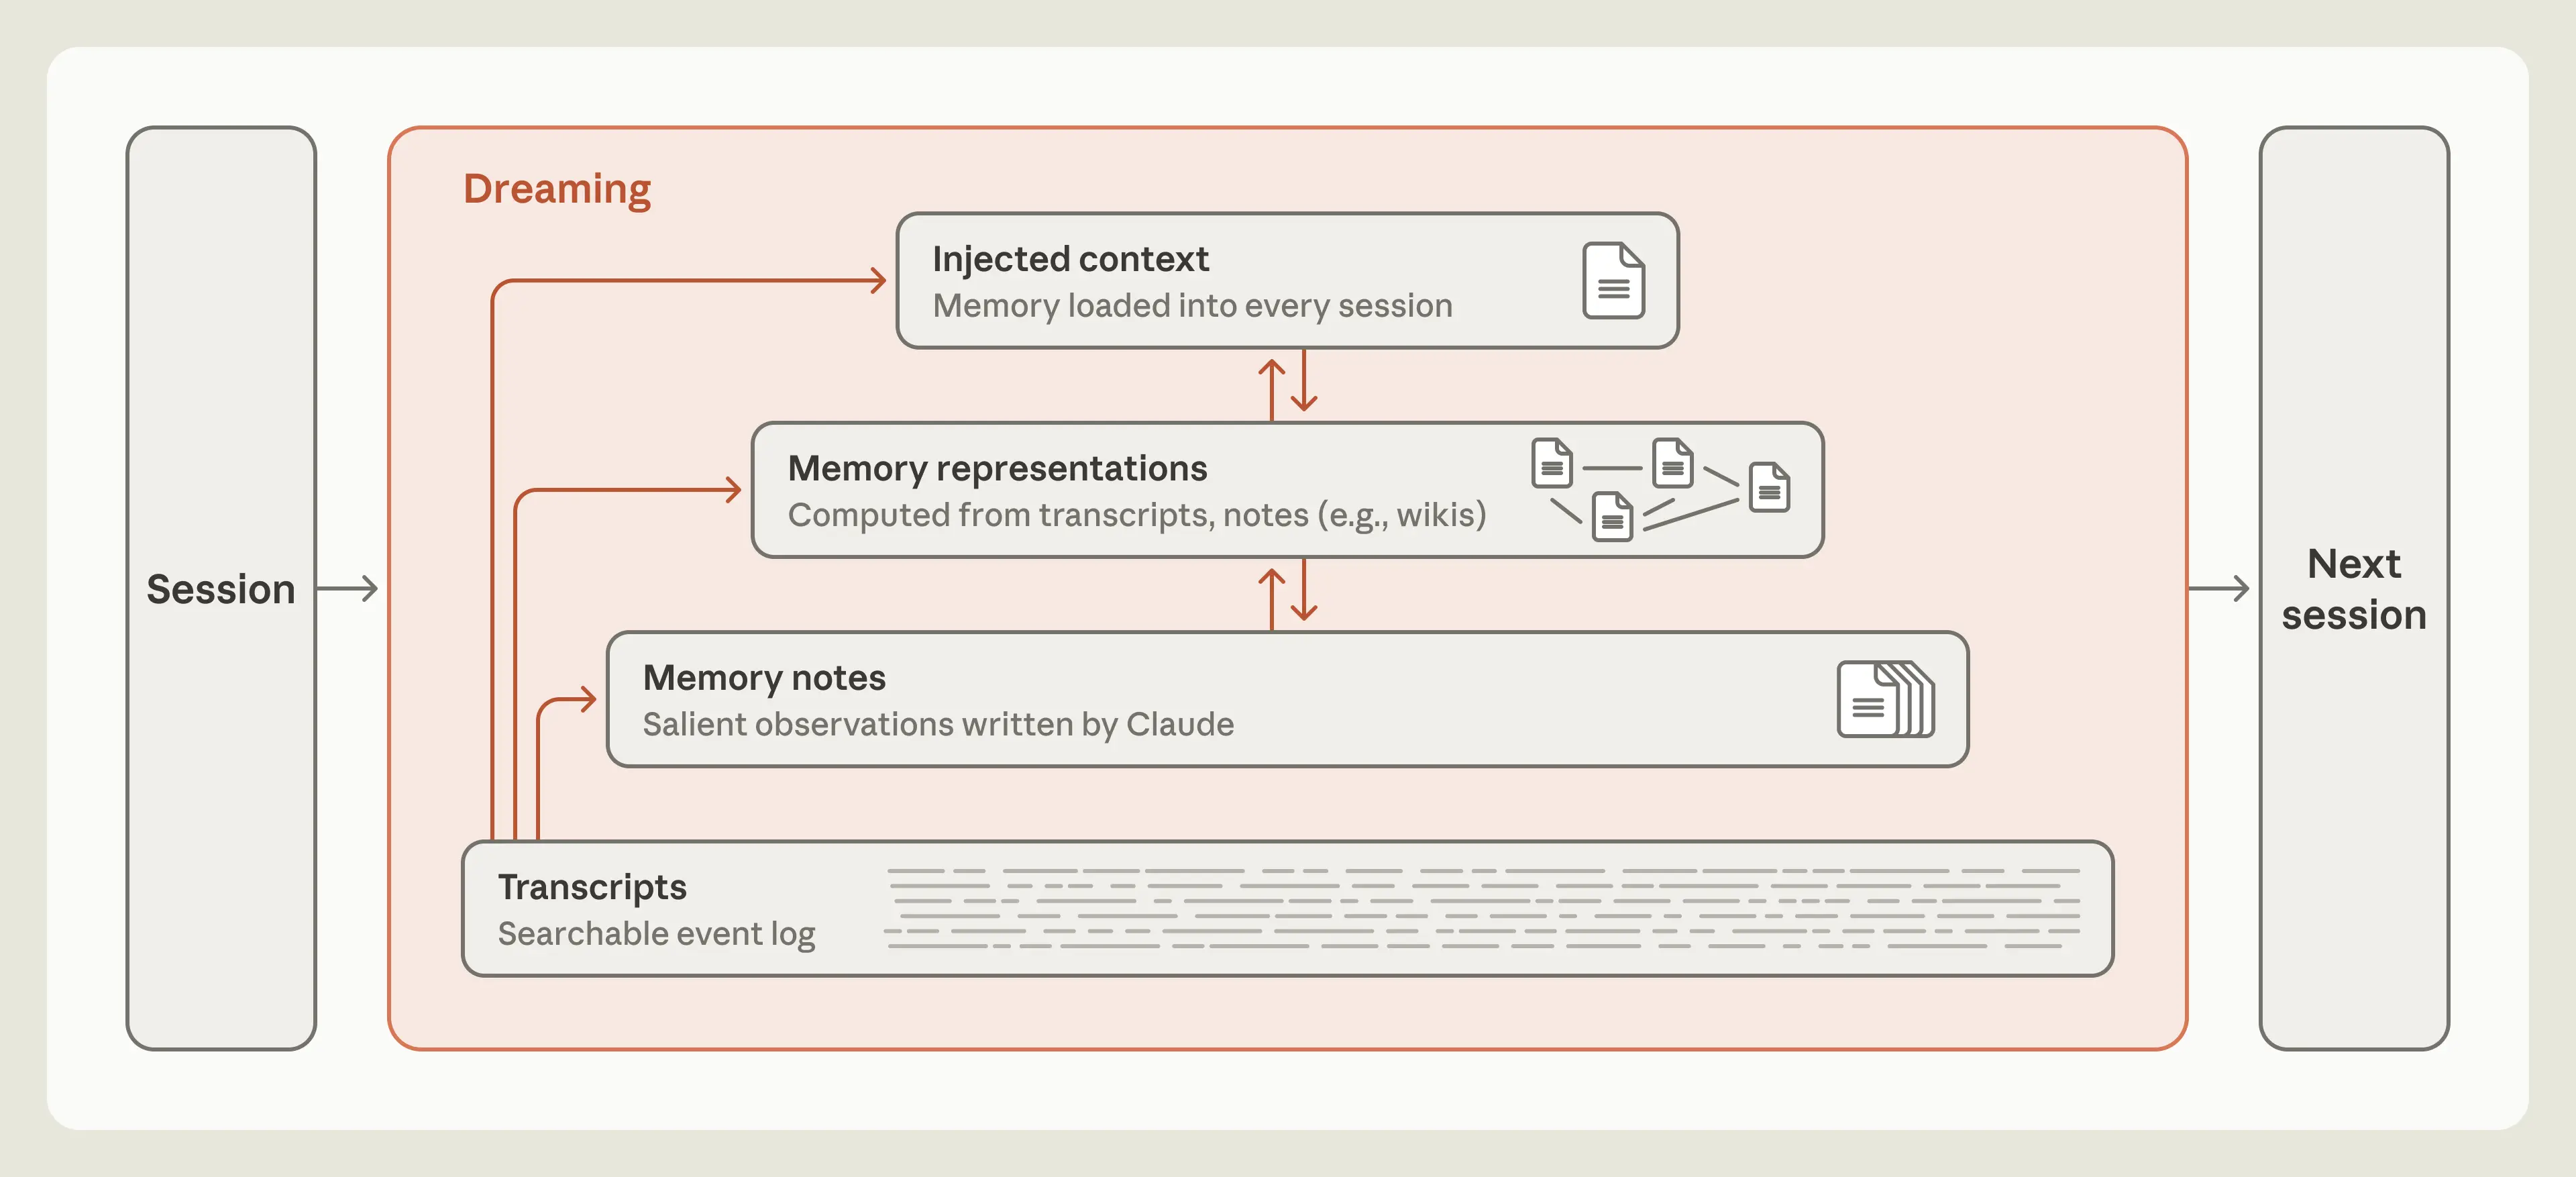
Memória de agente, no contexto de Claude, é tudo que o sistema aprende por experiência e mantém entre sessões, salvo como contexto externo que pode ser lido no futuro. Não envolve mudar pesos de rede, não é o aprendizado em contexto de uma conversa única e não se confunde com compaction. Essa distinção importa porque orienta a arquitetura em camadas, desde transcrições brutas, passando por notas curtas, por representações como wikis, até um topo de contexto injetado em novas sessões. (anthropic.com)
Na prática, isso cria uma hierarquia funcional. Transcrições são o rastro fiel do que ocorreu. Notas são hipóteses e regras escritas rapidamente durante a execução. Representações, como wikis, viram “mapas” navegáveis do conhecimento acumulado. O contexto injetado leva um subconjunto pequeno e preciso para o início de cada nova sessão, poupando buscas e janelas gigantes de contexto. Segundo a Anthropic, o ganho não vem de guardar tudo, e sim de decidir o que lembrar, quando revisar e como promover. (anthropic.com)
Dreaming, a peça que fecha o ciclo
Dreaming é o nome do ciclo offline que revisita transcrições, checa notas e atualiza representações quando o agente não está em diálogo com o usuário. É uma inspiração clara da consolidação de memória humana, só que com verificações determinísticas baseadas em logs. No material publicado em 6 de novembro de 2026, a Anthropic mostra que o Dreaming corrige anotações equivocadas, promove regras validadas e mantém a camada injetada pequena e focada, um ponto crítico para não desperdiçar tokens e evitar instruções longas que diminuem adesão. (anthropic.com)
Há convergências interessantes com pesquisas externas, como a proposta de “sleep‑time compute” da UC Berkeley e da Letta, que usa janelas de ociosidade para pré computar raciocínios úteis, reduzindo custo e latência de inferência. Essa linha reforça o valor de ciclos offline para organizar conhecimento. (arxiv.org)
Casos práticos, do CL-Bench ao Pokémon
Benchmarks importam porque forçam escolhas técnicas. No CL-Bench 1.0, uma das tarefas mede como o agente usa memória para responder perguntas a partir de um banco de dados. Claude escreve memórias entre perguntas, registra erros, elabora teorias, testa hipóteses e transforma descobertas em regras. Em medições reportadas pela Anthropic, modelos como Opus 5 e as variantes 5.5 fecharam o ciclo, usando memória para capturar regras validadas e elevar a pontuação em relação a baselines sem memória. Esse desenho isola o ganho de aprendizado online, e coincide com a meta do CL-Bench de medir se o sistema realmente melhora com experiência, em vez de apenas exibir capacidade estática. (anthropic.com)
Um exemplo lúdico torna isso concreto. Jogando Pokémon Red, versões de Claude com estilos diferentes de memória geraram resultados bem distintos. Sonnet 3.7 registrou quase tudo e terminou com centenas de arquivos, porém ficou lento e ineficiente porque muito do que salvava mudava a cada turno. Já Fable 5 escreveu poucas notas estruturadas, manteve um arquivo global com metas e regras de uso de memória, e avançou muito mais. O Dreaming, aplicado nesse cenário, corrigiu uma anotação errada sobre a localização do PokéCenter no Monte Moon e mudou o desfecho do jogo, levando Claude até Cerulean City. (anthropic.com)
Essa mesma lógica de escrever pouco e bem vale para rotinas de trabalho. Em vez de entupir a memória com estados de tela ou dados fáceis de recapturar, a ênfase está em registrar estratégia, planos e regras testadas que só existem se o agente as derivar. O Dreaming mantém essas peças vivas e confiáveis, já que compara notas com as transcrições e corrige desvios. (anthropic.com)
Construção de wikis, economia de tokens e quando a wiki ajuda mais
Representações como wikis são recursos para navegar um acervo crescente de notas. A Anthropic avaliou Claude em um corpus interno de cerca de 350 mil arquivos, com 420 milhões de tokens, e pediu aos agentes Opus 5 para explorarem o material, escreverem e corrigirem páginas, mesclarem duplicatas e checarem alegações contra as fontes, tudo em sessões sequenciais. À medida que o Dreaming escalou de 2 para 128 sessões, a pontuação agregada em um conjunto de 25 perguntas subiu de 13 por cento para 48 por cento usando apenas a wiki, e quando combinada com ferramenta de busca subiu de 54 por cento para 61 por cento, além de economizar aproximadamente 20 mil tokens por pergunta. (anthropic.com)
Nem sempre a wiki ganha do search. Em tarefas onde quase tudo está em um único documento e um grep bem feito resolve, o ganho foi nulo. Em contrapartida, quando a tarefa pedia combinar informações de vários arquivos e exigir julgamento ou aritmética, consultar a wiki elevou a pontuação para 87 por cento, contra 73 por cento com busca isolada. O insight é pragmático, construir mapas é valioso quando o território é grande e interconectado, e menos quando há um único documento dominante. (anthropic.com)
Como orientar o agente a escrever memória, sem engessar
Outra lição prática é sobre orientação. Dar regras rígidas, como “registre apenas falhas”, derrubou parte do ganho que a memória trazia para modelos fortes como Opus 4.7 e Opus 5. Já instruções simples sobre finalidade da memória, sem prescrever uso detalhado, funcionaram melhor. Para modelos mais antigos como Sonnet 4.6, orientar explicitamente a leitura de memória antes de responder e o teste de hipóteses quase dobrou a pontuação no benchmark de banco de dados. A mensagem é clara, permita julgamento de saliência pelos modelos mais capazes, e forneça trilhos objetivos quando a arquitetura ainda não tem esse comportamento emergente. (anthropic.com)
Quando promover memória para o topo e como evitar poluição de contexto
Promover notas para o topo da hierarquia, que injeta informações no início de cada sessão, é poderoso e perigoso. Anotações erradas podem contaminar muitas rodadas, e arquivos longos reduzem adesão às instruções. A própria documentação do Claude Code indica manter o cabeçalho de memória injetada pequeno, por exemplo, carregar apenas as primeiras centenas de linhas de um arquivo indexador. O resto fica navegável por links. O Dreaming ajuda aqui, promovendo o essencial e empurrando detalhes de volta para camadas inferiores, com rastros que preservam encontrabilidade. (anthropic.com)
Convergências na indústria, do Sleep Framework ao Sleep‑time Compute
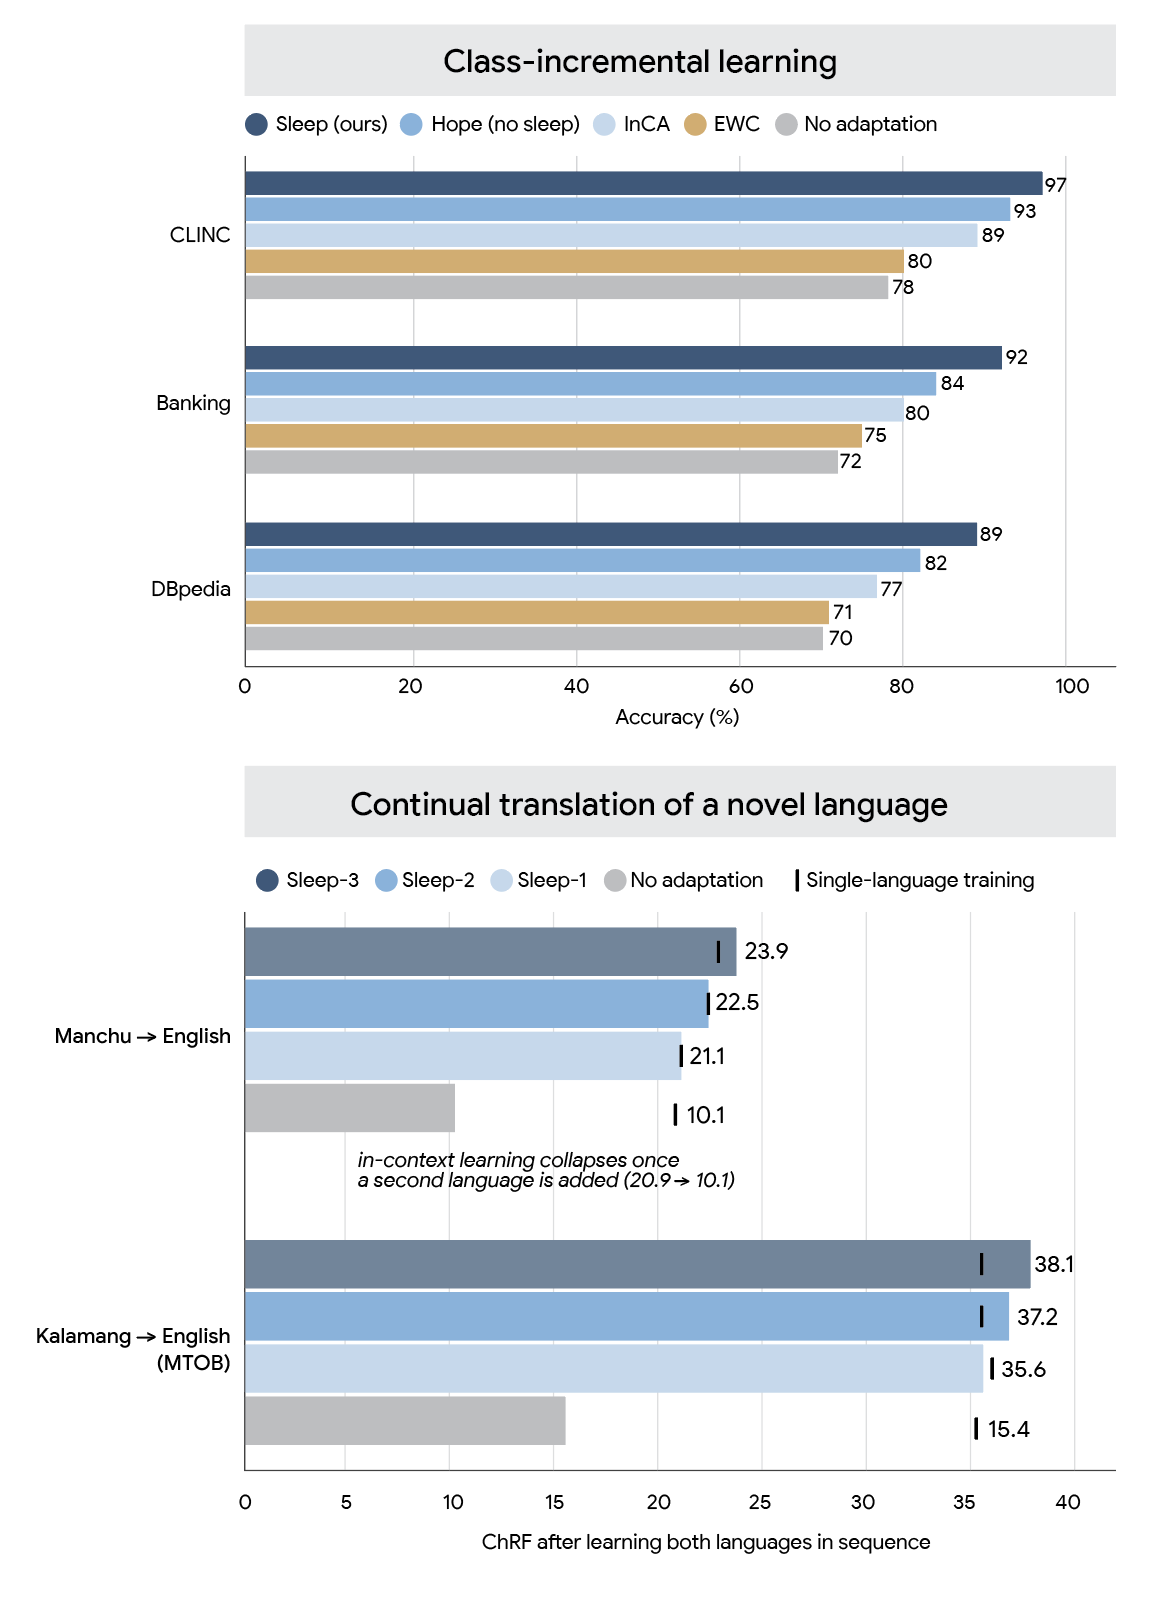
A indústria inteira vem testando ciclos offline para retenção de conhecimento e redução de custo. O Google Research publicou em 27 de outubro de 2026 o Sleep Framework, com uma fase de consolidação paramétrica e outra de Dreaming para autoaperfeiçoamento, reportando ganhos em aprendizado incremental, tradução contínua e raciocínio em longos contextos, além de retenção de até 10 milhões de tokens. O desenho alterna fases ativas com um sono que expande capacidade via Mixture of Experts e integra memórias de curto prazo em parâmetros de longo prazo. A proposta conversa diretamente com a ideia de memória de agentes, só que no nível dos pesos, enquanto a Anthropic focou na memória externa gerida por contexto. (research.google)
Já a noção de sleep‑time compute, apresentada por pesquisadores da UC Berkeley e Letta em 17 de abril de 2025, reforça um uso pragmaticamente valioso, antecipar perguntas prováveis, pré computar resultados e reduzir em cerca de 5 vezes o custo para manter a mesma acurácia em tarefas simbólicas, além de ganhos de até 18 por cento de acurácia ao escalar o sono. A peça comum é simples, mover parte do raciocínio para janelas ociosas, organizar conhecimento e baratear a resposta quando o usuário chama. (arxiv.org)
O que medir para não se enganar com “melhorias”
Benchmarks de agentes evoluíram para capturar melhoria real, não só capacidade estática. O CL-Bench, por exemplo, cobre seis domínios, de engenharia de software a previsão de demanda, e introduz uma métrica de ganho para isolar aprendizado online do que já vinha pré treinado. Já o LAB, da Harvey, mede trabalho jurídico de múltiplas etapas com rubricas detalhadas e tem sido usado para comparar arquiteturas e orientar pesquisa aplicada em agentes jurídicos. Em ambos, usar memória de forma eficaz, com ciclos de consolidação como o Dreaming, tende a mover o ponteiro onde importa, persistência de conhecimento útil, custo por tarefa e confiabilidade do fluxo de trabalho. (arxiv.org)
Guia prático, como aplicar componentes da memória de agentes
- Definir camadas antes do código. Transcrições completas, notas curtas orientadas a regras e representações, como um wiki que referencia as fontes. Use índices leves no topo, carregados no início de sessão, e deixe o grosso para busca. A hierarquia publicada pela Anthropic é um bom ponto de partida. (anthropic.com)
- Escrever notas preditivas, não históricas. Registrar fatos verificados, procedimentos e armadilhas, com o critério de utilidade futura. Anotações redundantes sobre estados voláteis, como valores que a ferramenta já lê toda hora, poluem a memória e desaceleram o agente, como visto no caso do Pokémon. (anthropic.com)
- Implantar um ciclo de Dreaming. Em janelas ociosas, reprocessar transcrições, validar notas, corrigir erros e promover um subconjunto mínimo para o topo. Para tarefas estáveis e previsíveis, considerar sleep‑time compute para pré computar raciocínios caros. (arxiv.org)
- Orientar sem engessar. Dê objetivos para a memória e métricas de qualidade, como cobertura de fontes e evidências associadas, mas permita julgamento de saliência para modelos mais fortes. Regras rígidas, como registrar apenas falhas, podem reduzir ganho. (anthropic.com)
- Medir com benchmarks apropriados. Para fluxos de conhecimento distribuído em muitos documentos, avaliar se uma wiki eleva precisão e reduz custo de tokens. Onde um único arquivo domina, priorizar boas ferramentas de busca. (anthropic.com)
Reflexões e insights ao longo da prática
Memória de agentes é sobre escolher bem. Quanto mais uma equipe tenta guardar tudo, mais paga em latência, custos e confusão. Dreaming funciona porque troca pressa por verificação, confronta anotações com a realidade das transcrições e expurga o que não resiste a evidência. Em benchmarks que exigem juntar pistas de vários lugares, o ganho é visível, assim como a economia de tokens quando a wiki amadurece. (anthropic.com)
Há uma fronteira complementar entre duas linhas de P&D, consolidar memória externa navegável, como propõe a Anthropic, e consolidar memória nos próprios parâmetros, como discutem o Sleep Framework e o sleep‑time compute. Para produtos, as duas camadas podem coexistir, memórias externas para rastreabilidade e explicabilidade, memórias paramétricas para acesso instantâneo quando o SLA exige mínima latência. (research.google)
Conclusão
Agentes úteis não precisam lembrar de tudo, precisam lembrar do que muda o comportamento. O processo Dreaming do Claude oferece um caminho prático para organizar memória de agentes, corrigir notas falhas e construir representações que reduzem custo e ampliam precisão. Em evidências publicadas em 6 de novembro de 2026, a Anthropic mostra ganhos concretos, de banco de dados a fluxos jurídicos, além de lições de design como evitar regras que engessam saliência e manter leve o topo injetado. (anthropic.com)
As próximas evoluções vão combinar ciclos offline mais inteligentes com melhores critérios de promoção e descarte. À medida que benchmarks como CL-Bench e LAB amadurecem, vai ficar mais fácil separar hype de progresso e provar que o que foi escrito em memória gera retorno mensurável em velocidade, custo e qualidade de entrega. (arxiv.org)
Leia também
Claude GA no Google Cloud, paridade total da API
A Plataforma Claude chegou ao Google Cloud em disponibilidade geral, com paridade total de recursos da API. Com a oferta Anthropic gerenciada, clientes ativam Claude no ecossistema Google com os mesmos lançamentos, políticas de dados e recursos do endpoint nativo, simplificando adoção e governança.
9 min de leituraTecnologia e IAAnthropic destina 5%+ ações a Public Benefit Fund de IA
A Anthropic anunciou a criação de um Public Benefit Fund com 5% das ações, com possibilidade de aumento conforme a valorização. Entenda por que isso importa para o ecossistema de IA, como funciona a estrutura de governança, o que muda para investidores e sociedade, e como se compara a modelos como o da OpenAI.
10 min de leituraIA conversacionalxAI lança Grok Voice 3.0, o fala a fala mais inteligente
Grok Voice 3.0, da xAI, promete conversas mais naturais com latência sob 1 segundo, liderança em índices de fala para fala e uso em escala em Tesla, SpaceX e Starlink. O modelo chega à API pelo mesmo preço da versão anterior, focado em agentes de voz que resolvem tarefas de ponta a ponta.
9 min de leituraIA e SegurançaAnthropic dá ao METR acesso de empregado para checar riscos de IA
A Anthropic concedeu ao METR acesso de empregado para checar riscos de IA, com seis avaliadores integrados usando hardware e ferramentas internas. O movimento promete avaliações mais rigorosas e transparentes, em linha com a pressão por auditorias independentes depois de incidentes recentes em testes de segurança. Entenda o que muda, o que o METR pode publicar e por que isso redefine governança, compliance e engenharia de segurança em modelos avançados.
11 min de leitura