Runway corta custo de GPU pela metade, vídeo 57B em tempo real roda em 4 H100
Runway detalha como levou um modelo de vídeo autoregressivo de 57B para tempo real com batch size 1, reduzindo de 8 para 4 H100 por sessão, e o que isso muda para custos, latência e casos de uso interativos.

Danilo Gato
Autor
Introdução
Runway corta custo de GPU pela metade em um modelo de vídeo em tempo real de 57B, que agora roda a 24 fps com batch size 1 em apenas quatro H100 por sessão. No lançamento, o sistema exigia oito H100 para manter a cadência do vídeo, o que elevava custos e limitava a escala. As otimizações tornaram possível sustentar 159,3 ms por passo de difusão, com médias acima de 23,5 fps em produção, preservando a qualidade percebida de lip sync. (runway.com)
O avanço importa porque tempo real muda a economia de geração, reduz tempo de espera e viabiliza experiências interativas como avatares conversacionais que respondem com a mesma cadência humana. Quando cada sessão é privada e não pode se beneficiar de batching, eficiência por passo e por GPU define viabilidade técnica e custo por usuário. (runway.com)
O que a Runway entregou, em números
O sistema por trás do Runway Characters serve um modelo autoregressivo de cerca de 57 bilhões de parâmetros a 24 fps, emitindo um novo bloco de quatro frames a cada 166,7 ms em resolução 704x1088, com batch size 1. Cada passo faz quatro passagens de difusão por quadro latente, somando 240 chamadas de atenção por passo. As otimizações reduziram o tempo do passo de 240,9 ms para 159,3 ms, e com um kernel fundido chegaram a 147,4 ms em testes, enquanto em produção as sessões sustentaram acima de 23,5 fps na imensa maioria dos casos. (arxiv.org)
Além da taxa de frames, a arquitetura equilibra latência de conversas. Em medições reais, um turno de fala médio ficou em 2,13 s do fim da fala do usuário até o áudio do avatar no cliente, sendo 1,42 s atribuídos ao agente de voz. A parte do pipeline de vídeo da Runway responde por cerca de 0,49 s, e a entrega até o navegador adiciona aproximadamente 190 ms. (runway.com)
Como rodar 57B em tempo real com batch size 1
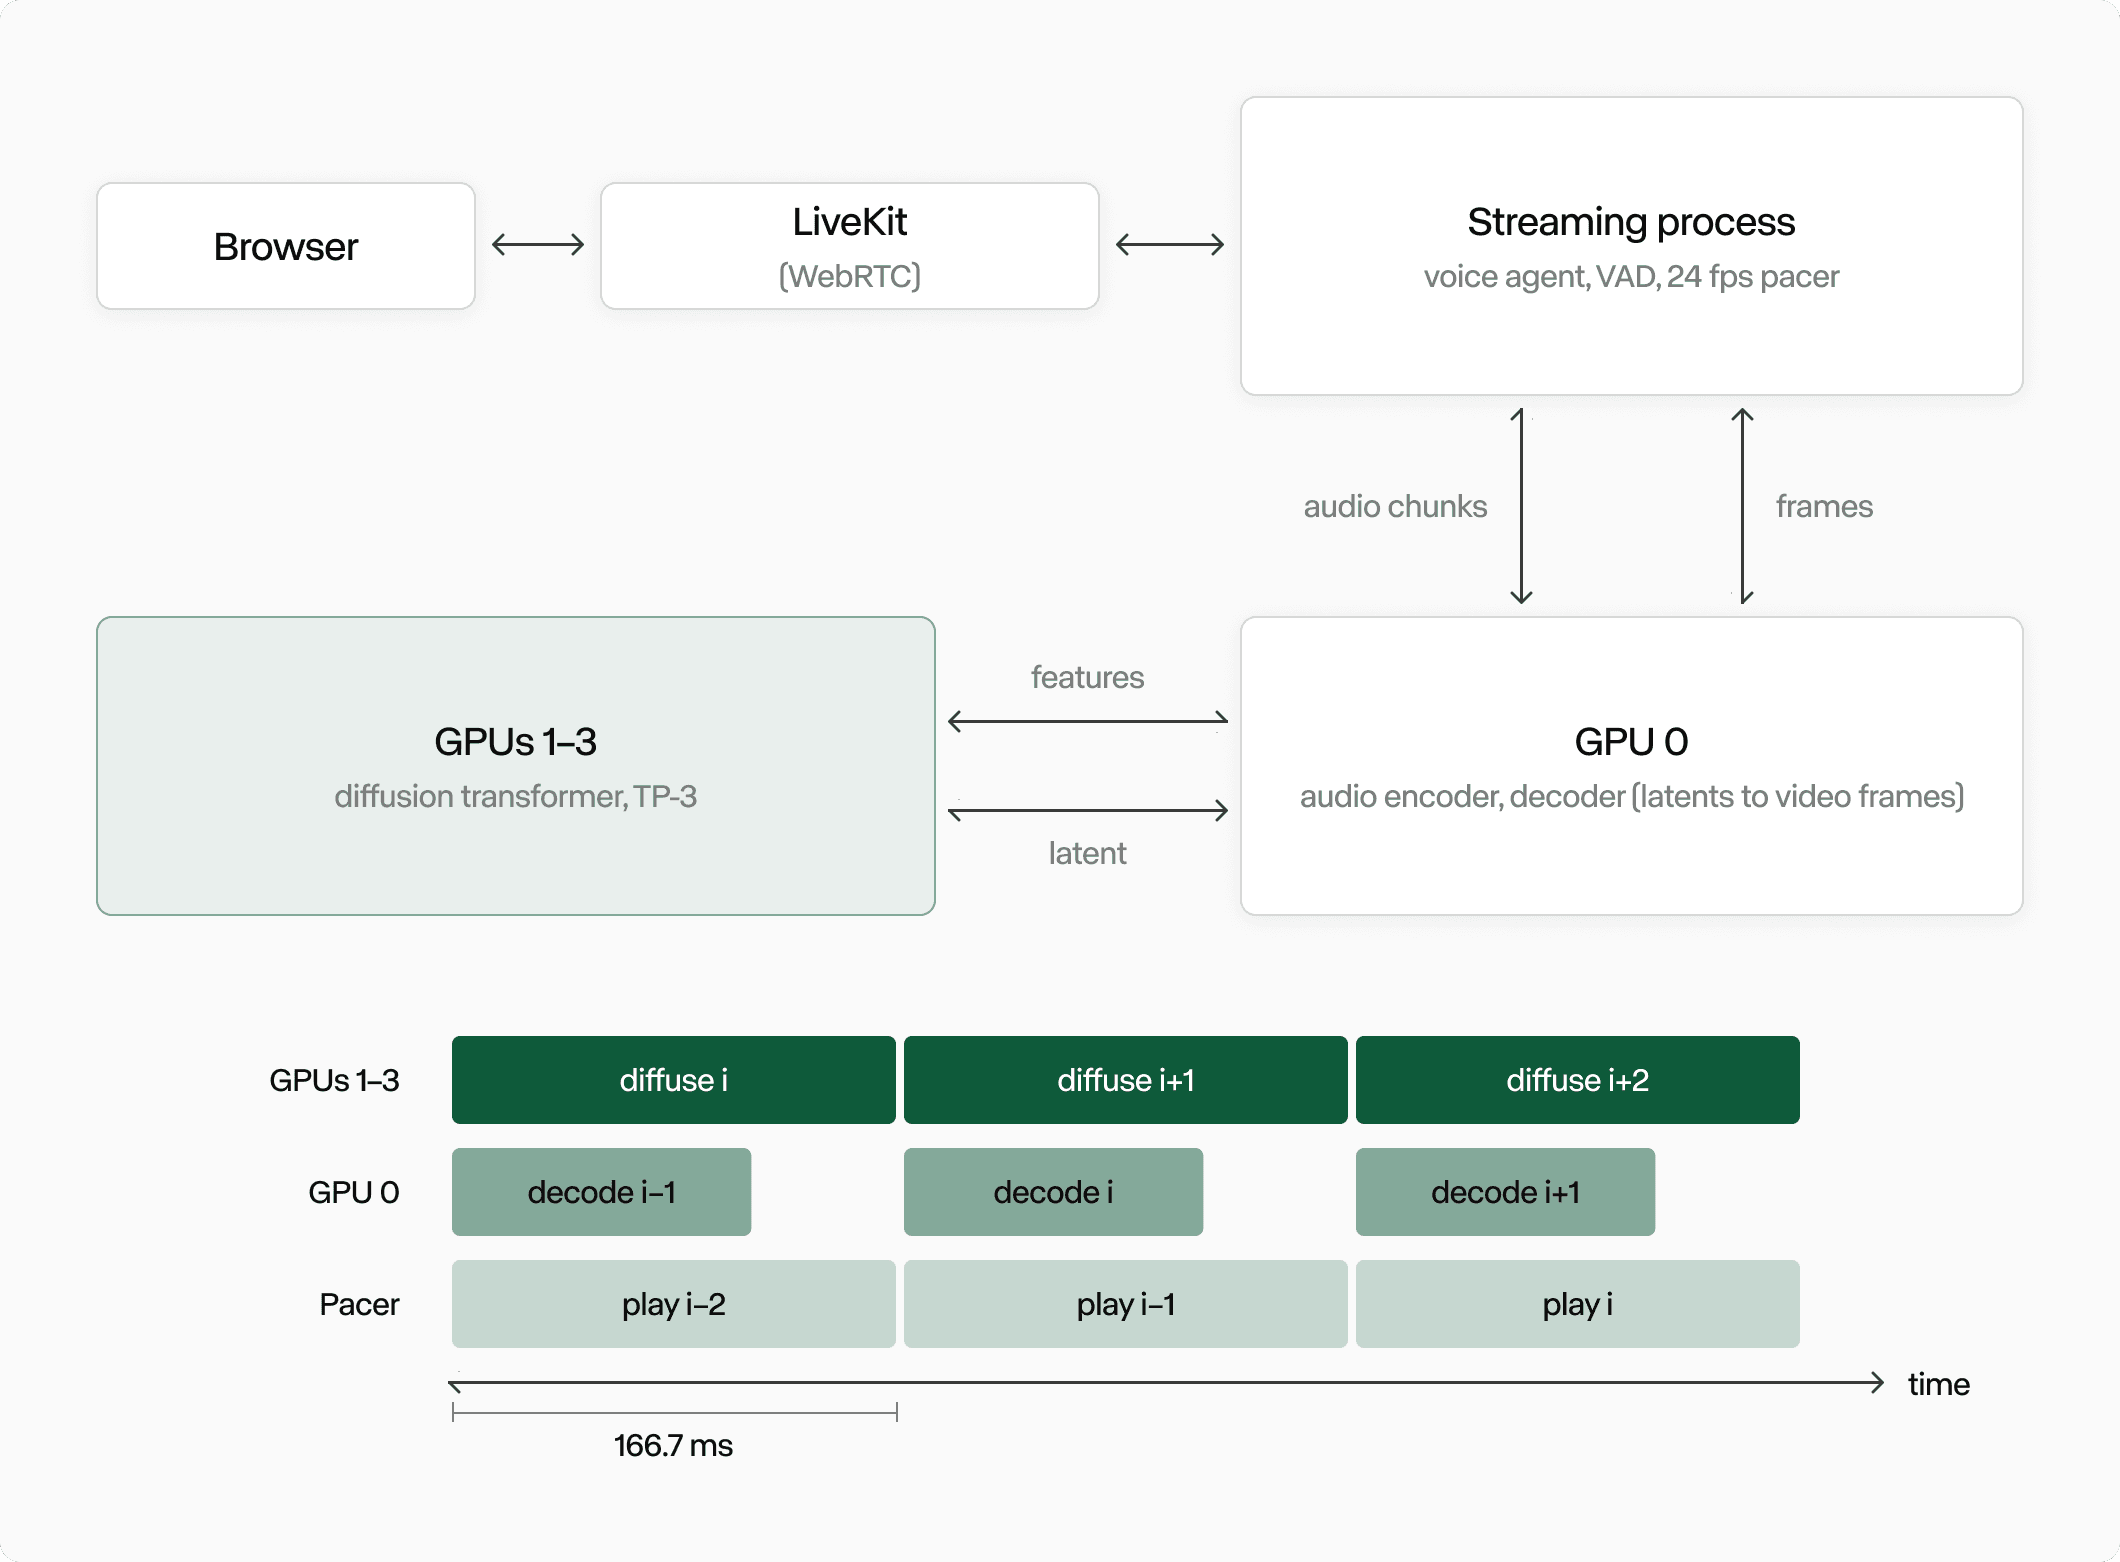
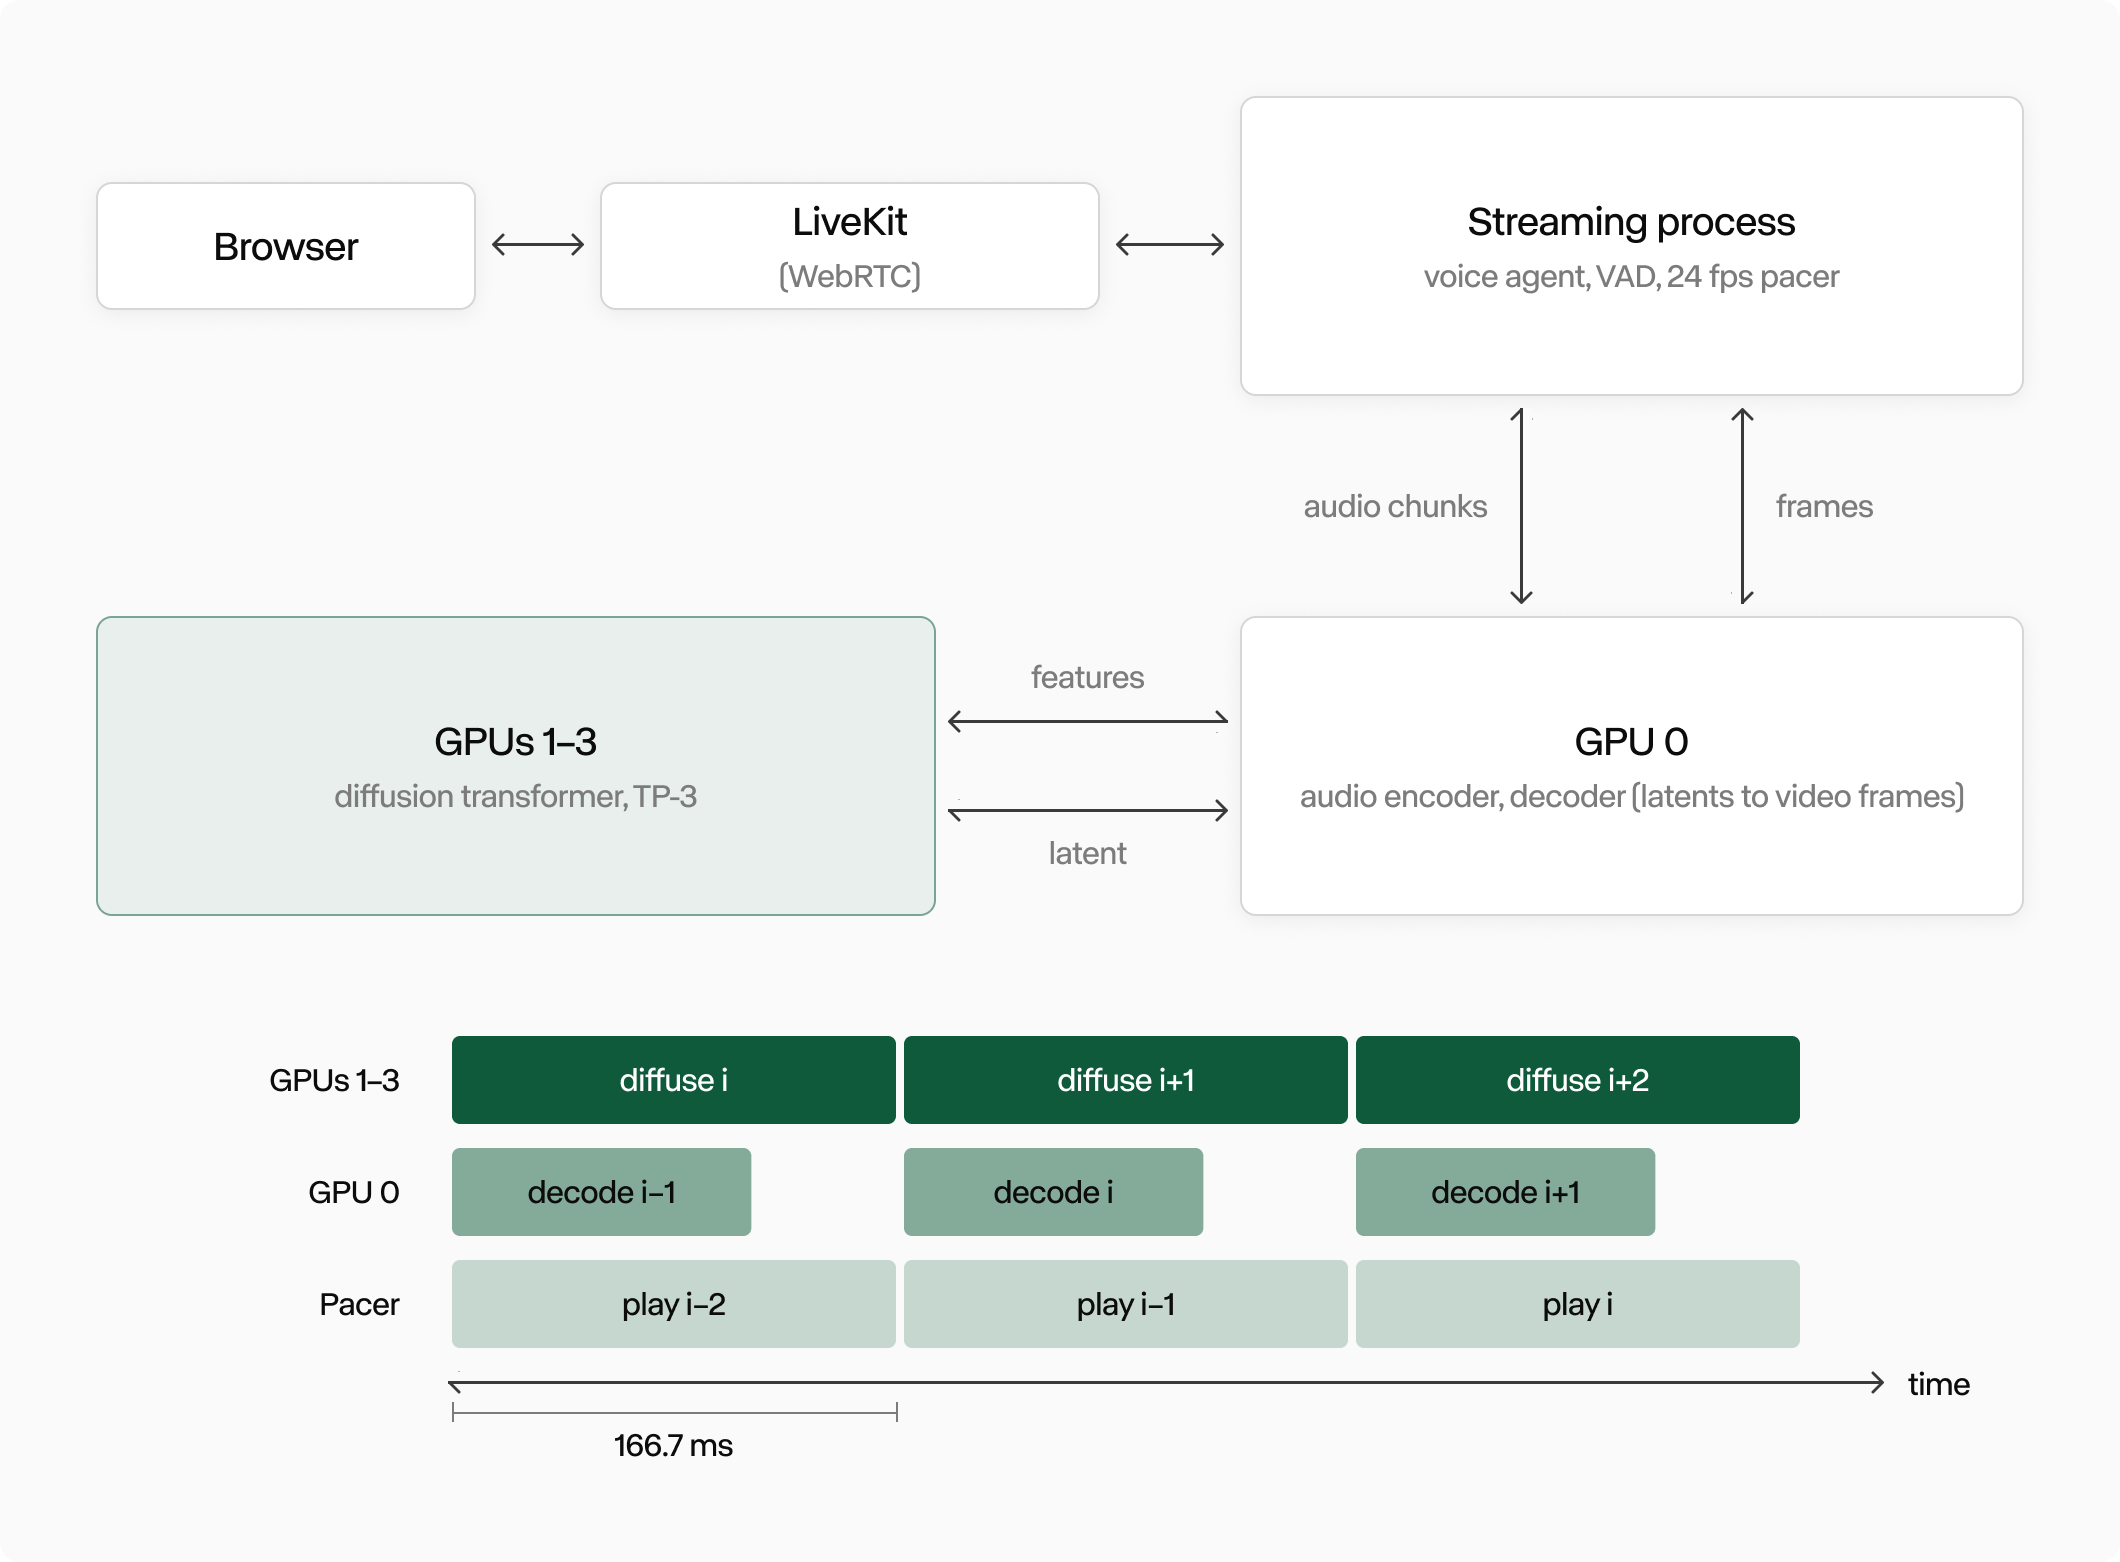
O gargalo de sistemas para tempo real não é throughput agregado, e sim cumprir prazos rígidos por sessão, sem batching. Em 24 fps, a carga útil chega a 2,24 PFLOP/s por sessão, acima do pico denso de FP8 de uma única H100, por isso escalar por sessão exige paralelismo entre GPUs e redução drástica de sobrecusto por passo. O desenho da Runway usa paralelismo de tensor, três H100 dedicadas ao transformador e uma H100 separada para decodificação de latentes em frames, ancorando o período do passo em 159,3 ms. (runway.com)
A primeira virada veio ao mover trabalho do tempo de leitura para o tempo de escrita no KV-cache. Em vez de reprojetar posições rotatórias e re-quantizar todo o cache a cada chamada de atenção, o sistema aplica RoPE e quantização FP8 quando o frame entra no cache, organizando-o em anel para avançar a janela sem cópias. Só essa mudança derrubou a manutenção do cache de 69,7 ms para 6,2 ms por passo. (runway.com)
Em seguida, a equipe fundiu o all-reduce de paralelismo de tensor diretamente no kernel de GEMM FP8, reduzindo blocos de saída no switch NVLink enquanto os próximos tiles ainda estão sendo computados. Com isso, entre 54 por cento e 68 por cento do tempo de comunicação foi ocultado. Somando essas melhorias, o passo de difusão alcançou 147,4 ms com o kernel fundido e 159,3 ms sem ele, mantendo a estabilidade de qualidade avaliada por métricas de sincronização labial. (runway.com)
Outra decisão crítica foi isolar o decodificador de latentes em uma GPU dedicada. A decodificação consome cerca de 114 ms por passo. Se compartilhasse uma das GPUs de difusão, criaria um gargalo serial, atrasando o grupo de paralelismo de tensor. Separado, o decodificador trabalha no chunk anterior enquanto a difusão avança o próximo, deixando um restante serial de apenas 1,6 ms por passo. (runway.com)
De 8 para 4 H100, o que mudou no custo e na operação
No lançamento, cada sessão do Characters exigia oito H100. Na mesma época, um arranjo com quatro H100 ainda ficava acima do orçamento de 166,7 ms por passo, medindo 240,9 ms. As otimizações descreveram um caminho prático, com ganhos de 1,51 vezes sem o kernel fundido, permitindo cumprir o prazo em quatro H100 por sessão. Em produção, com sete semanas de telemetria, 99,5 por cento das sessões sustentaram acima de 23,5 fps, e após um rollback do kernel fundido seguido de correção, a taxa de sessões abaixo de 24 fps caiu drasticamente. (runway.com)
Em termos de unidade econômica, reduzir de 8 para 4 H100 por sessão corta pela metade a reserva de GPU necessária para experiências realmente interativas. Isso importa porque cada sessão é privada, com batch size 1, então a conta não se dilui em filas. Embora preços variem por provedor e contrato, otimizações desse tipo deslocam o teto de viabilidade de aplicativos com vídeo responsivo, principalmente quando o modelo mantém fidelidade visual e consistência temporal em 704x1088. (arxiv.org)
Qualidade, métricas e compromissos técnicos
Comparações pixel a pixel perdem significado em modelos autoregressivos, já que diferenças mínimas de ponto flutuante mudam a trajetória do vídeo em segundos. A avaliação migrou para o que importa na tarefa, como lip sync, medido com SyncNet em 51 clipes e em sessões de 10 minutos, sem degradação detectável além da variação entre execuções idênticas. Essa estratégia foca se as mudanças de kernel e cache afetam o que o usuário percebe, não se batem pixels. (runway.com)
Outro ponto sensível é a interação entre vídeo e áudio no loop. O pipeline compartilha orçamento com o agente de voz, que isoladamente já adiciona cerca de 1,30 s ao intervalo entre turnos, de acordo com benchmarks acadêmicos. Com medição ponta a ponta de 2,13 s por turno mediano, otimizações de vídeo que economizam dezenas de milissegundos ainda são relevantes, mas o maior ganho futuro virá do lado de voz, rede e orquestração. (runway.com)
Blackwell, escalabilidade e limites do decodificador
Nem toda otimização de H100 se transfere automaticamente para B200. O cache em FP8, por exemplo, economiza 17,0 ms em H100, mas custa entre 2,4 ms e 6,7 ms em B200 no build atual, que não inclui um kernel de atenção FP8 com escalas por cabeça. Em oito H100, a difusão cai para 118,2 ms por passo, mas o decodificador, executando em uma única GPU, passa a ditar o tempo de ciclo, mantendo o período do passo em 128,7 ms, cerca de 31 fps. Ou seja, mais GPUs aceleram a difusão, não o decodificador. (runway.com)
Esse desenho reforça o conselho prático para quem projeta sistemas de vídeo generativo, priorizar o balanceamento entre difusão e decodificação. Uma GPU dedicada ao decodificador remove gargalos de longo rabo e permite que otimizações de kernel em difusão realmente repercutam no período final do passo. É por isso que o ganho de um kernel fundido aparece mais quando o decodificador sai do caminho crítico. (runway.com)
Como isso se conecta à tendência maior de vídeo em tempo real
A corrida por vídeo em tempo real não é exclusiva da Runway. Trabalhos recentes como Helios e LongLive mostram FPS altos com uma H100, em contextos e pilhas distintas, reforçando a direção do campo em sustentar taxas de vídeo contínuas, com compromissos diferentes de qualidade, resolução e latência interativa. O que diferencia o caso da Runway é demonstrar um modelo de 57B, com voz no loop, rodando em produção a 24 fps, em resolução superior, sob batch size 1. (arxiv.org)
Para quem quer trazer experiências interativas a produtos, a referência útil é a definição operacional de tempo real usada aqui, 166,7 ms por chunk de quatro frames, stream contínuo por sessão única e orquestração que aceite interrupções do usuário. Modelos distilados para poucos passos por frame e uma pilha de inferência otimizada para latências p50 e p99, não só throughput médio, são o núcleo da estratégia. (arxiv.org)
Aplicações práticas e dicas de adoção
Para equipes de produto que avaliam quando migrar de geração por job para geração em streaming, três passos práticos emergem desta engenharia:
- Escolher a arquitetura e o caminho de distilação certos. A Runway descreve uma abordagem em duas fases, convertendo o professor bidirecional em gerador causal e depois distilando até poucos passos por frame, mantendo fidelidade. Esse processo reduz o custo por saída sem sacrificar estabilidade visual. (runway.com)
- Medir e otimizar o caminho crítico por sessão. Mapear o orçamento do passo, quantizar onde dá retorno e fundir comunicação com computação quando possível. Tratar cache como dado quente no write, não no read, reduz trabalho repetido e libera margem para cumprir 24 fps. (runway.com)
- Isolar decodificação e áudio. Em conversas, cada 100 ms de atraso vira experiência quebrada. Uma GPU dedicada ao decodificador e um pipeline que sobreponha áudio, difusão e playout mantêm fluidez. O maior potencial de ganho adicional pode estar fora do modelo, no agente de voz e na rede. (runway.com)
Para quem oferta APIs, custos em créditos e perfis de cobrança por segundo já aparecem em plataformas comerciais, o que evidencia como latência e passos por frame impactam diretamente o preço percebido por cliente. Modelos mais rápidos, ainda que maiores, podem sair mais baratos por segundo útil de vídeo quando sustentam FPS alvo e reduzem retries. (docs.dev.runwayml.com)
Reflexões e insights
A maior lição é simples, tempo real é uma propriedade de sistema, não apenas do modelo. Com batch size 1, não existe ganho mágico de batching, então a engenharia tem que caçar milissegundos dentro do passo, da memória ao kernel, e da orquestração ao decodificador. O resultado, cortar de oito para quatro H100 por sessão mantendo 24 fps, prova que atenção aos detalhes compensa quando a meta é interatividade e não só qualidade estática. (runway.com)
Outro insight, qualidade percebida precisa de métricas alinhadas com a tarefa. Em pipelines autoregressivos, comparar pixels não diz o que o usuário sente. Métricas como SyncNet, que capturam alinhamento audiovisual, ajudam a evitar otimizações que ganham milissegundos ao custo de estranheza na boca ou quebra na fala. Em última instância, a métrica final é a fluidez do diálogo. (runway.com)
Conclusão
O trabalho recente da Runway mostra que tempo real para vídeo generativo de alta fidelidade é factível em escala de produto. A combinação de cache aplicado na escrita, kernel fundido e decodificação isolada entregou 24 fps com batch size 1 em quatro H100 por sessão, mantendo sincronização labial e reduzindo custos por usuário. Para quem constrói experiências com avatares e direção de cena em tempo real, é um novo patamar de referência técnica. (runway.com)
A próxima fronteira está em integrar essas técnicas com pilhas de voz mais rápidas e redes de distribuição otimizadas, além de migrar aprendizados para GPUs Blackwell sem perder os ganhos obtidos em Hopper. Enquanto isso, a tendência do setor confirma a direção, vídeo em tempo real como padrão para aplicações interativas, do suporte virtual ao entretenimento e à educação imersiva. (runway.com)
Leia também
Anthropic lança Claude Legal, artefatos e 60+ conectores
A Anthropic apresentou artefatos no Claude para trabalhos jurídicos, com dashboards de revisão contratual e mais de 60 conectores. Entenda como esses recursos reduzem retrabalho, trazem rastreabilidade e conectam sistemas legais ao fluxo do time, com exemplos práticos e recomendações.
9 min de leituraSEO e IAGoogle adota padrão IETF AIPREF no robots.txt
O Google anunciou apoio a um controle unificado de treinamento de IA via robots.txt, baseado no trabalho AIPREF do IETF. A proposta permite que editores expressem preferências de uso para treinamento com um único sinal, reduzindo fricção e preparando terreno para um padrão amplo do setor. Veja o que muda, prós, limites e como se preparar.
9 min de leituraTecnologiaMeta lança Style Sketch, app de moda com IA e Closet do Instagram
A Meta lançou o Style Sketch, um app de moda com IA que cria um closet digital a partir do Instagram, sugere combinações com as roupas que você já possui e ainda planeja looks por clima e viagem. Disponível inicialmente em Indonésia, Singapura e Tailândia, o app aposta na integração com o Instagram para competir com rivais como o Google Photos Wardrobe e a Alta. Entenda recursos, limitações, privacidade e o que isso sinaliza para o futuro do varejo fashion.
11 min de leituraInteligência ArtificialMeta lança Waddle World, app de diário com IA para pets nas Filipinas
Waddle World é o novo app da Meta que transforma conversas rápidas em entradas de diário com doodles gerados por IA, embalado em um bichinho virtual 16 bit. Disponível apenas nas Filipinas, o app sugere uma estratégia mais ampla da empresa para popularizar agentes de IA com apelo lúdico e mascotes cativantes.
10 min de leitura